4.4.2.2 挂载nfs 报错 backup device is not read and write strongly consistent.

【 使用环境 】生产环境 or 测试环境
【 OB or 其他组件 】observer-4.4.2.2
【 使用版本 】OceanBase 构建版本号:4.4.2.2-102000022026071514
【问题描述】在4.4.2.2 挂载nfs 做租户备份,报错,如下
【复现路径】问题出现前后相关操作
【附件及日志】推荐使用OceanBase敏捷诊断工具obdiag收集诊断信息,详情参见链接(右键跳转查看):

【SOP系列 22 】——故障诊断第一步(自助诊断和诊断信息收集)

【备注】基于 LLM 和开源文档 RAG 的论坛小助手已开放测试,在发帖时输入 [@论坛小助手] 即可召唤小助手,欢迎试用!

执行以下 SQL 失败
ALTER SYSTEM SET DATA_BACKUP_DEST='file:///DDBackup/nd/catl_cloudDB_ND/35/tenant_incarnation_1/1110/data' tenant=ICP
失败原因:
ErrorCode = 9153, SQLState = HY000, Details = backup device is not read and write strongly consistent. 172.18.46.53:2882 did not read the latest data written by 172.19.35.201:2882.

我查看了这两台服务器的nfs 挂载命令都是一致的,也是按照官方 参数来设置的

sudo mount -t ceph 172.18.4.xx,172.18.4.xx,172.18.4.xx:6789:/  /ceph_bak  -o name=admin,secret=xxxxxx

mount -tnfs -o rw,nfsvers=4.1,sync,lookupcache=positive,hard,timeo=600,wsize=1048576,rsize=1048576,namlen=255 127.0.0.1:/ceph_bak/  /DDBackup/

53:

[root@obs13 ~]# mount |grep nfs
nfsd on /proc/fs/nfsd type nfsd (rw,relatime)
sunrpc on /var/lib/nfs/rpc_pipefs type rpc_pipefs (rw,relatime)
127.0.0.1:/ceph_bak on /DDBackup type nfs4 (rw,relatime,sync,vers=4.1,rsize=1048576,wsize=1048576,namlen=255,hard,proto=tcp,timeo=600,retrans=2,sec=sys,clientaddr=127.0.0.1,lookupcache
=pos,local_lock=none,addr=127.0.0.1)

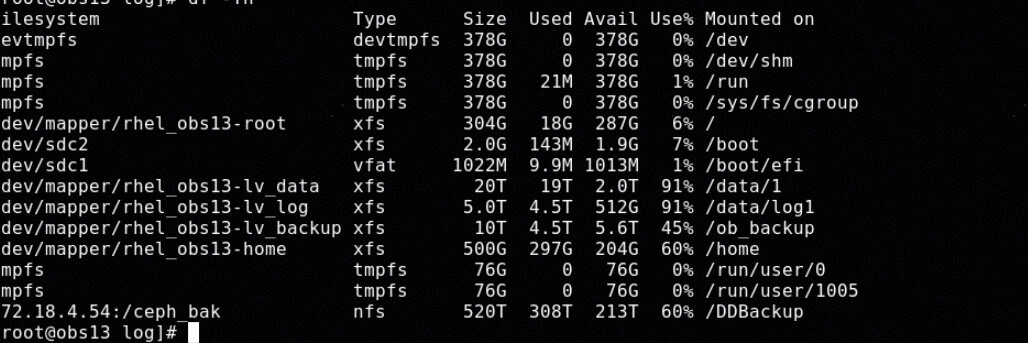
201:

[root@obs04 ~]# mount |grep nfs 
sunrpc on /var/lib/nfs/rpc_pipefs type rpc_pipefs (rw,relatime)
nfsd on /proc/fs/nfsd type nfsd (rw,relatime)
127.0.0.1:/ceph_bak on /DDBackup type nfs4 (rw,relatime,sync,vers=4.1,rsize=1048576,wsize=1048576,namlen=255,hard,proto=tcp,timeo=600,retrans=2,sec=sys,clientaddr=127.0.0.1,lookupcache
=pos,local_lock=none,addr=127.0.0.1)

根据您的描述,在执行租户备份时遇到了关于NFS设备读写强一致性的问题。对于这种情况,推荐您使用obdiag工具来收集与问题相关的诊断信息。这可以帮助我们更准确地定位导致错误的具体原因。

日志采集场景: 数据备份问题
日志采集命令: obdiag gather scene run --scene=observer.backup

这条命令将帮助您自动收集OceanBase系统中可能与备份功能异常相关的所有重要信息,包括但不限于配置文件、运行时状态及关键日志等。请您按照上述指令操作,并在完成后将得到的日志压缩包分享给我们以便进一步分析。

为了能够更加有效地解决您所遇到的问题,请您回答以下几个问题以提供更多背景细节:

  1. 当前使用的NFS服务器版本是什么?是否存在多个NFS服务器实例?
  2. 执行备份命令前后是否有查看过相关NFS挂载点的状态?比如使用mount或df -h命令输出。
  3. 是否尝试过直接对NFS共享目录进行简单的文件创建、删除测试,以确认其确实具备读写能力?
  4. 您能否提供执行备份时的确切命令以及完整的错误信息?
  5. 之前该环境中是否成功完成过类似的租户数据备份?

这些问题的答案有助于缩小问题范围,加快故障排除过程。期待您的回复!

附上敏捷诊断工具 obdiag 使用帮助链接

看着信息是当前挂载看起来“都有 /DDBackup + sync”,但本质是每机本地 NFS,不是 OB 要的共享强一致盘。

先做一次跨节点验证
在写方机器:
echo “ob_check_$(date +%s)” > /DDBackup/.ob_rw_test

sync

md5sum /DDBackup/.ob_rw_test

hostname; ip addr | grep 'inet ’

立刻在另一台机器:
cat /DDBackup/.ob_rw_test

md5sum /DDBackup/.ob_rw_test

hostname; ip addr | grep 'inet ’

  • 若读不到或 MD5 不一致:就是存储一致性问题,先修挂载/后端
  • 若偶尔能读到、有延迟才一致:也不满足 OB 要求

再确认两边底层是否真是同一套盘:
– 两台都执行
showmount -e 127.0.0.1
df -h /DDBackup
stat /DDBackup
–若能看到 ceph/nfs-ganesha 导出源,继续核对是否同一 pool/path

后端是一个ceph集群 转换成nfs ,提供ob备份使用。

按照我上面的测试一下 看看 OceanBase file:// 备份要求:所有相关 observer 挂到同一共享导出,且跨客户端强一致。

ALTER SYSTEM SET log_archive_dest='location=file:///DDBackup/nd/catl_cloudDB_ND/35/tenant_incarnation_1/1004/clog' tenant=HBI
失败原因:
ErrorCode = 9153, SQLState = HY000, Details = backup device is not read and write strongly consistent. 172.18.46.53:2882 did not read the latest data written by 172.18.46.87:2882.

测试 172.18.46.53、172.18.46.87 机器 读写是否同步,测试了1分钟 ,目前没发现问题。
2、后端ceph 是一个存储池,

172.18.4.53,172.18.4.54,172.18.4.55:6789:/  520T  307T  213T  60% /ceph_bak
127.0.0.1:/ceph_bak                         520T  307T  213T  60% /DDBackup

53:

[root@obs13 log]# stat /ceph_bak
  File: ‘/ceph_bak’
  Size: 30        Blocks: 0          IO Block: 65536  directory
Device: 0h/0dInode: 1           Links: 1
Access: (0777/drwxrwxrwx)  Uid: (  500/ UNKNOWN)   Gid: (  500/ UNKNOWN)
Access: 1970-01-01 08:00:00.000000000 +0800
Modify: 2026-11-11 11:27:03.249045007 +0800
Change: 2026-11-11 11:27:03.249045007 +0800
 Birth: -

87:

[root@obs56 ~]# stat /ceph_bak
  File: /ceph_bak
  Size: 30        Blocks: 0          IO Block: 65536  directory
Device: 30h/48dInode: 1           Links: 29
Access: (0777/drwxrwxrwx)  Uid: (  500/ UNKNOWN)   Gid: (  500/ UNKNOWN)
Access: 1970-01-01 08:00:00.000000000 +0800
Modify: 2026-11-11 11:27:03.249045007 +0800
Change: 2026-11-11 11:27:03.249045007 +0800
 Birth: -

这个你设置以后报错 把observer.log发一下 看看

你具体说一下 nfs你怎么挂载的 201、53、87、54、55 挂载的都是同一台么?

ALTER SYSTEM SET log_archive_dest='location=file:///DDBackup/nd/catl_cloudDB_ND/35/tenant_incarnation_1/1004/clog' tenant=HBI
失败原因:
ErrorCode = 9153, SQLState = HY000, Details = backup device is not read and write strongly consistent. 172.18.46.53:2882 did not read the latest data written by 172.18.46.87:2882.

[root@obs13 log]# grep  YB42AC122E58-00066586F65B2979-0-0   observer.log 
[2026-11-11 13:48:58.311660] INFO  get_fd (ob_fd_simulator.cpp:202) [19111][T1_L0_G0][T1004][YB42AC122E58-00066586F65B2979-0-0] [lt=25] fd simulator stat(used_fd_cnt=1, total_fd_cnt=30
0, alloc_fd_cnt=55, release_fd_cnt=54, second_array_num=1, array_size=300)
[2026-11-11 13:48:58.348062] WDIAG [COMMON] finish (ob_io_define.cpp:1020) [69889][IO_SYNC_CH0][T0][YB42AC122E58-00066586F65B2979-0-0] [lt=11][errcode=0]  REACH SYSLOG RATE LIMIT [band
width]
[2026-11-11 13:48:58.441038] WDIAG [COMMON] finish (ob_io_define.cpp:1020) [69889][IO_SYNC_CH0][T0][YB42AC122E58-00066586F65B2979-0-0] [lt=12][errcode=0] invalid storage id(storage_inf
o={storage_id:18446744073709551615, storage_used_mod:2})
[2026-11-11 13:48:58.441113] WDIAG [SERVER] process (ob_rpc_processor_simple.cpp:4992) [19102][T1_L0_G0][T1004][YB42AC122E58-00066586F65B2979-0-0] [lt=5][errcode=-9153] crc64 does not 
match, backup device is not read & write strong consistent(ret=-9153, ret="OB_BACKUP_DEVICE_NOT_STRONG_RW_CONSISTENT", arg={tenant_id:1004, backup_dest_str:"file:///DDBackup/nd/catl_cl
oudDB_ND/35/tenant_incarnation_1/1004/clog/check_file/1004_nfs_connectivity_check_1794376138127481.obbak", data_checksum:992725592, file_len:314})

你具体说一下 nfs你怎么挂载的 201、53、87、54、55 挂载的都是同一台么?

这后面是3台 大盘服务器 搭建的一个ceph 池 , 对外统一提供 6789 端口 , 172.18.4.53,172.18.4.54,172.18.4.55:6789

我在observer 挂载的 是ceph ,然后observer 把ceph 转nfs 协议 提供给ob租户 备份

observer 端:

sudo mount -t ceph 172.18.4.53,172.18.4.54,172.18.4.55:6789:/  /ceph_bak  -o name=admin,secret=11111111

mount -tnfs -o rw,nfsvers=4.1,sync,lookupcache=positive,hard,timeo=600,wsize=1048576,rsize=1048576,namlen=255 127.0.0.1:/ceph_bak/  /DDBackup/

底层 Ceph 是一套池没错;但 OB 走的是每机本地 NFS 二次挂载,不满足它对 backup device 的跨节点强一致检查。
日志里的 crc64 does not match 就是这个架构的典型表现。优先改成 CephFS 直挂 /DDBackup,或 统一 NFS VIP。

你的意思 是 在observer端 不转协议,直接 在observer端 以nfs协议 挂ceph 存储 ?

现在是 这么挂载的:


改成:

是这个意思吗?我测试下,这个crc64 强一致性校验是4.4.2.2 改的吧 ,我记得4.3.5 ,4.2.5 没这个限制。

是的 目前你挂载试一下

刚测试了下,clog 正常能正常开启,我在测试一下备份。

归档和备份 都能正常。
我有个疑问,4.4.2.2 为啥 要改这个 强一致性校验,备份延迟 也没啥大问题。

441就已经有了

  1. 真实故障反复出现
    典型案例:NFS 没按 sync 挂载,备份时报 -4016(读到空/不完整文件,failed to read file trailer)。根因是「一个节点写成功,另一个节点立刻读不到最新数据」。
  2. 老检查不够
    4.2 / 4.3 主要看挂载是否存在、权限是否够,不验证跨节点写后即读是否一致。挂错参数、本机二次 NFS、缓存不一致,都能蒙混过关。
  3. 把风险前移
    只在设置 DATA_BACKUP_DEST / log_archive_dest 时做一次强校验:写校验文件 → 其他节点立刻读 → 比对长度和 crc64。
    失败就明确报 -9153,而不是备份跑到一半才 -4016。