
用 4 行代码,给你的 AI 应用外接记忆

想象一下这样的场景:
你正在和一个 AI 医疗助手聊天,它刚刚帮你记录了头痛的症状。第二天,你再次咨询时,它竟然完全忘记了你是谁,还要你重新介绍一遍病情…
是不是很抓狂?
这就是传统 AI 应用的"金鱼记忆"问题 —— 每次对话都是"初次见面",永远记不住历史信息。
但今天,我要告诉你一个极佳的解决方案:PowerMem + seekdb —— 一个让 AI 拥有 “超强记忆力” 的持久化记忆系统!
数据说话:48.77% 准确率提升,96.53%成本降低!
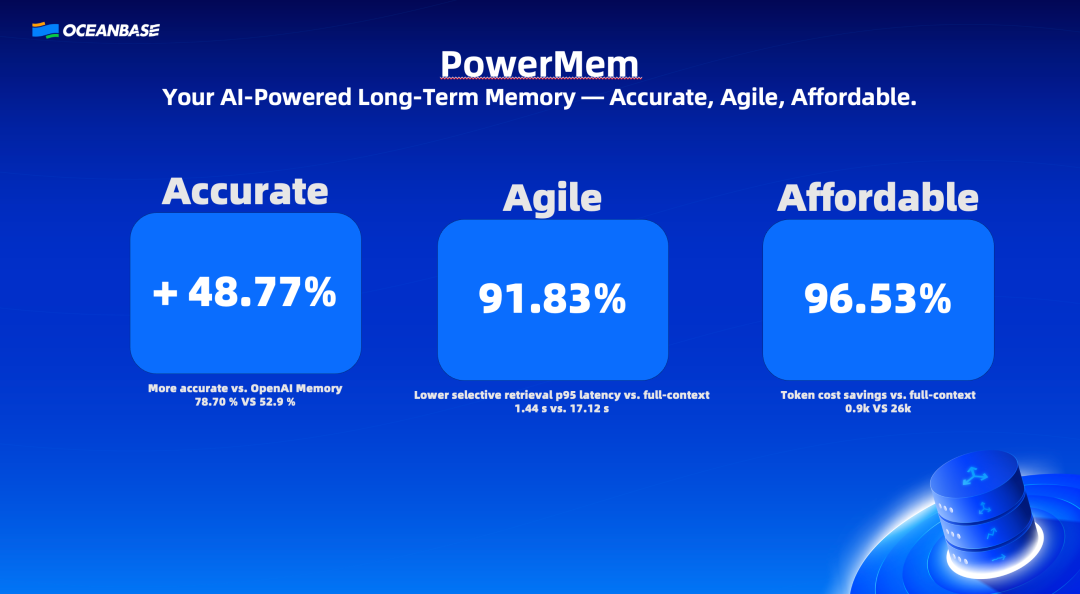
先看一组压测数据:
-
 准确率提升 48.77%:在 LOCOMO 基准测试中,准确率从 52.9% 提升至 78.70%
-
 响应速度快 91.83%:检索延迟从 17.12 秒降至 1.44 秒
-
 Token 用量降低 96.53%:从 26k 降至 0.9k,成本暴降!
这意味着什么?
你的 AI 应用不仅能记得更准,还能答得更快,同时花得更少!
不是简单的"记事本",而是"最强大脑"
PowerMem 是什么?
PowerMem 建立在这样一个原则之上:AI 系统应该能够像人类一样随着时间积累知识和经验。这一理念驱动了 PowerMem 设计和实施的每个方面:
- 智能提取和保留:PowerMem 通过 LLM 模型进行记忆的提取,根据重要性和相关性确定哪些信息值得记住。
- 上下文理解:PowerMem 维护跨交互的上下文以实现有意义的个性化体验。
- 持续学习:PowerMem 使 AI 系统能够从每次交互中学习并随着时间的推移而改进。
- 自适应遗忘:像人类记忆一样,PowerMem 实现了自适应遗忘机制以防止信息过载。
PowerMem 的核心特性包括:
-
开发者友好
-
轻量级接入方式[1]:提供简洁的 Python SDK / MCP支持,让开发者快速集成到现有项目中
-
智能记忆管理
-
记忆的智能提取[2]:通过 LLM 自动从对话中提取关键事实,智能检测重复、更新冲突信息并合并相关记忆,确保记忆库的准确性和一致性。
举个例子:还记得上学时老师让你划重点吗?PowerMem 就是 AI 的"学霸助手"!
# 用户说了一堆话
messages = [
    {"role": "user", "content": "Hi, my name is Alice. I'm a software engineer at Google."},
    {"role": "assistant", "content": "Nice to meet you, Alice!"},
    {"role": "user", "content": "I love Python programming and machine learning."}
]

# PowerMem 自动提取关键事实
memory.add(messages=messages, user_id="alice", infer=True)

# 结果:自动提取出 4 条关键记忆
# 1. Name is Alice
# 2. Is a software engineer at Google
# 3. Loves Python programming
# 4. Loves machine learning
不需要你手动标注,AI 自动帮你"划重点"!
- 艾宾浩斯遗忘曲线[3]:基于认知科学的记忆遗忘规律,自动计算记忆保留率并实现时间衰减加权,优先返回最近且相关的记忆,让 AI 系统像人类一样自然"遗忘"过时信息
还记得那个著名的遗忘曲线吗?PowerMem把它用在了AI记忆上!
 最近的信息:权重高,优先召回
 久远的信息:权重低,自然衰减
 过时信息:自动清理,保持记忆库新鲜
就像人类大脑一样,重要的、最近的信息记得更牢!
-
多智能体支持
-
智能体共享/隔离记忆[4]:为每个智能体提供独立的记忆空间,支持跨智能体记忆共享和协作,通过作用域控制实现灵活的权限管理
-
多模态支持:不仅记得文字,还 “看得懂” 图片
-
文本、图像、语音记忆[5]:自动将图像和音频转换为文本描述并存储,支持多模态混合内容(文本 + 图像 + 音频)的检索,让 AI 系统理解更丰富的上下文信息
# 存储图片记忆
memory.add(
    messages=[{"role": "user", "content": "这是我的X光片"}],
    images=["xray_image.jpg"],
    user_id="patient_001"
)

# 搜索时,文字 + 图片一起检索
results = memory.search("X光片结果", user_id="patient_001")
- 深度优化数据存储
- 支持子存储(Sub Stores)[6]:通过子存储实现数据
的分区管理,支持自动路由查询,显著提升超大规模数据的查询性能和资源利用率 - 混合检索[7]:融合向量检索、全文搜索和图检索的多路召回能力,通过 LLM 构建知识图谱并支持多跳图遍历,精准检索复杂的记忆关联关系
seekdb 是什么?
OceanBase seekdb 是 OceanBase 打造的一款开发者友好的 AI 原生数据库产品,专注于为 AI 应用提供高效的混合搜索能力,支持向量、文本、结构化与半结构化数据的统一存储与检索,并通过内置 AI Functions 支持数据嵌入、重排与库内实时推理。 seekdb 在继承 OceanBase 原核心引擎高性能优势与 MySQL 全面兼容特性的基础上,通过深度优化数据搜索架构,为开发者提供更符合 AI 应用数据处理需求的解决方案。
PowerMem + seekdb (1 + 1 >2 ) 的持久化记忆解决方案
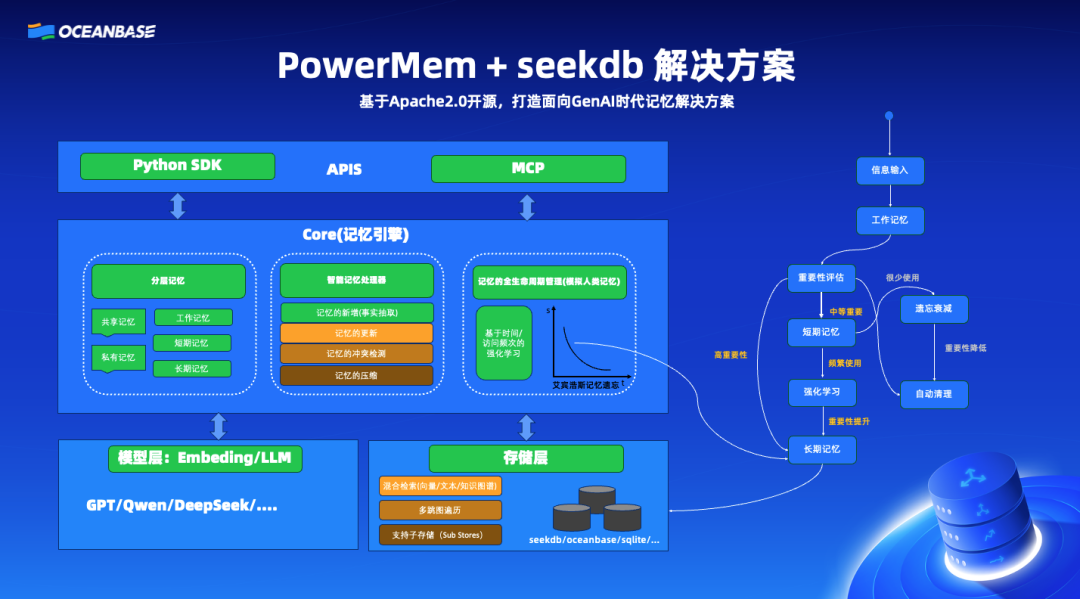
PowerMem 的架构旨在模块化、可扩展,包括如下层:
- 核心记忆引擎 (core):管理所有记忆操作,包括智能记忆处理器、分层记忆管理、全生命周期记忆管理模块
- 模型层:提供与流行 LLM 和嵌入模型的无缝集成
- 存储层:支持多种存储后端的灵活接口。特别的,我们在 seekdb / oceanbase 上做了深度适配,充分利用了 seekdb 的混搜能力
所以,PowerMem + seekdb 的组合不是简单的数据存储,而是一个真正智能的持久化记忆系统。
1 分钟快速上手:让 AI 秒变"记忆大师"
第一步:安装
pip install powermem
第二步:使用
from powermem import Memory, auto_config

# 自动从 .env 加载配置
memory = Memory(config=auto_config())

# 添加记忆(自动提取事实)
memory.add("用户喜欢喝咖啡", user_id="user123")

# 搜索记忆(智能检索)
results = memory.search("用户偏好", user_id="user123")
就这么简单!4 行 python 代码,让你的 AI 拥有"记忆力"!
结语:是时候给 AI 装个"外挂记忆"了!
还在为 AI 的 “金鱼记忆” 而烦恼吗?
还在为 Token 成本居高不下而头疼吗?
还在为检索准确率低而困扰吗?
PowerMem 来了!
-
 准确率提升 48.77%
-
响应速度快 91.83%
-
成本降低 96.53%
让 AI 拥有"最强大脑",从 PowerMem 开始!
**
**
 相关资源
- PowerMem GitHub 仓库[8]
- seekdb GitHub 仓库[9]
- PowerMem 官方网站[10]
- seekdb 官方网站[11]
至此,正文结束。
What’ s more?
不懂技术的 OceanBase 社区运营小编,看到靖顺老哥在正文中吹嘘的 “一分钟快速上手”,深表怀疑。因此特地根据步骤,复制黏贴上文的命令,来验证和记录一下。
pip install powermem

git clone https://github.com/oceanbase/powermem.git

cd powermem

cp .env.example .env
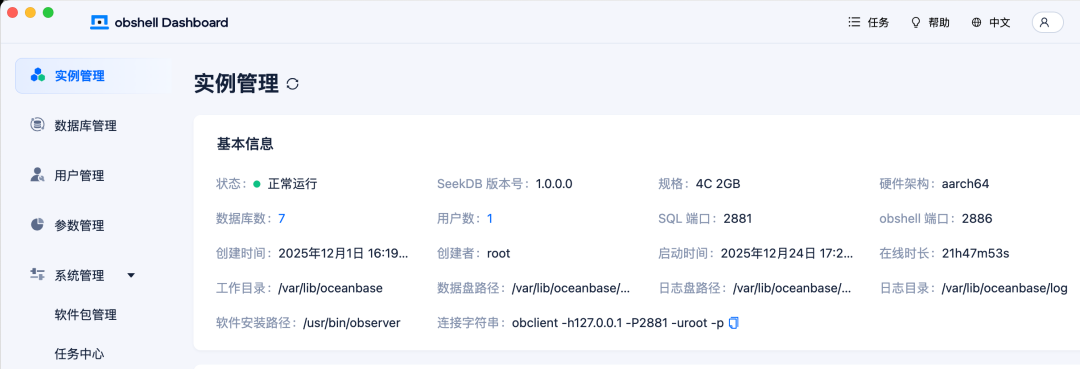
之前小编已经在自己的 mac 笔记本上安装过 seekdb 的桌面版,全程都只需要在白屏点击“下一步”。(桌面版安装包在这里:OceanBase 分布式数据库 - 海量数据 笔笔算数
根据 github 上的 “入门指南”,还需要简单调整下 .env 文件,主要是改一下配置文件中 OceanBase 或者 seekdb 的 ip、port 信息,以及填一下模型服务的 API KEY。
下图是小编 .env 调整前后的 vimdiff。
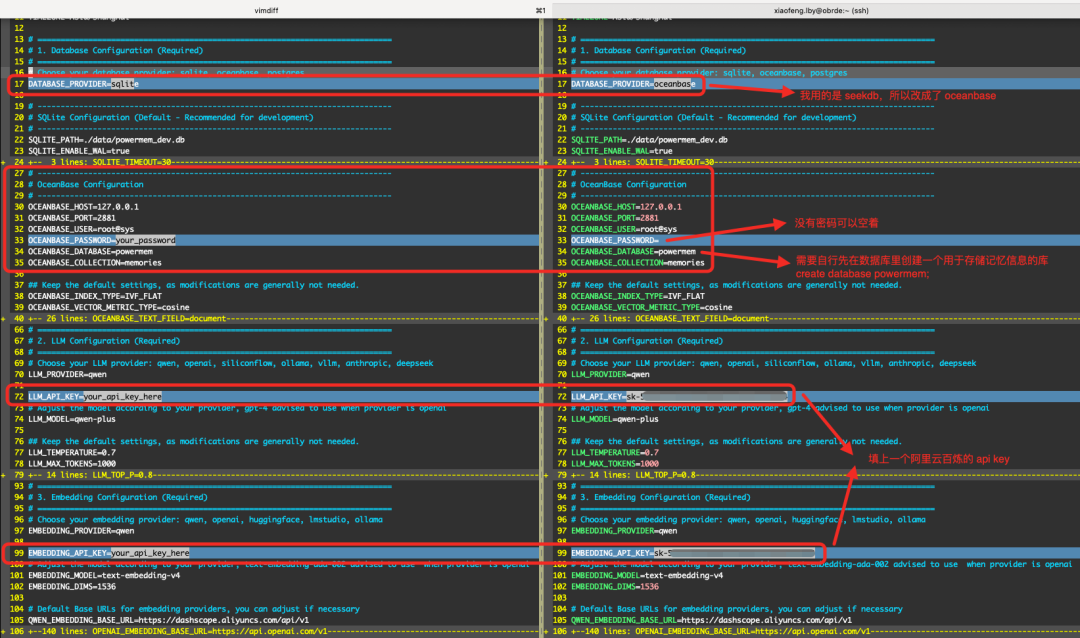
看配置文件,应该是会把 powermem 的记忆信息存储到我本地的 seekdb 里一个叫 powermem 的库里,需要手动先给它创建出来。
% seekdb
Welcome to the MySQL monitor.  Commands end with ; or \g.
Server version: 5.7.25 OceanBase 4.3.5.3 SeekDB (r1.0.0.0)
Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.

mysql> create database powermem;
Query OK, 1 row affected (0.12 sec)
复制 github 上的示例 python 文件,这里除了靖顺老哥上面展示的 4 行,还多了两行查询和展示记忆存储结果的。
% cat test.py

from powermem import Memory, auto_config

# Load configuration (auto-loads from .env)
config = auto_config()
# Create memory instance
memory = Memory(config=config)

# Add memory
memory.add("User likes coffee", user_id="user123")

# Search memories
results = memory.search("user preferences", user_id="user123")
for result in results.get('results', []):
    print(f"✓ Found: {result.get('memory')}")
什么也不需要改动,直接执行即可,看上去结果是符合预期的。PowerMem 的测试,比预想的要顺利很多,运营同学也能快速完成,欢迎大家试用!
% python3 test.py
✓ Found: Likes coffee
感兴趣的老师们,还可以再去看下 powermem 在 seekdb 里面是怎么存储 “记忆” 的?
% seekdb
Welcome to the MySQL monitor.  Commands end with ; or \g.
Server version: 5.7.25 OceanBase 4.3.5.3 SeekDB (r1.0.0.0)
Type 'help;'or'\h'for help. Type '\c' to clear the current input statement.

mysql> use powermem

mysql> show tables;
+--------------------+
| Tables_in_powermem |
+--------------------+
| memories           |
+--------------------+
1 row in set (0.00 sec)

mysql> desc memories;
+------------------+--------------+------+-----+---------+-------+
| Field            | Type         | Null | Key | Default | Extra |
+------------------+--------------+------+-----+---------+-------+
| id               | bigint(20)   | NO   | PRI | NULL    |       |
| embedding        | VECTOR(1536) | YES  |     | NULL    |       |
| document         | longtext     | YES  |     | NULL    |       |
| metadata         | json         | YES  |     | NULL    |       |
| user_id          | varchar(128) | YES  |     | NULL    |       |
| agent_id         | varchar(128) | YES  |     | NULL    |       |
| run_id           | varchar(128) | YES  |     | NULL    |       |
| actor_id         | varchar(128) | YES  |     | NULL    |       |
| hash             | varchar(32)  | YES  |     | NULL    |       |
| created_at       | varchar(128) | YES  |     | NULL    |       |
| updated_at       | varchar(128) | YES  |     | NULL    |       |
| category         | varchar(64)  | YES  |     | NULL    |       |
| fulltext_content | longtext     | YES  |     | NULL    |       |
+------------------+--------------+------+-----+---------+-------+
13 rows in set (0.00 sec)

mysql> select * from memories\G
*************************** 1. row ***************************
              id: 659224926074437632
       embedding: [0.0383122,-0.0106654,-0.0383817,-0.00595737,0.00112351,-0.0235866,0.00142427,-0.0117586,0.0508979,0.119379,0.0584863,-0.0144712,0.0182538,-0.0602446,0.0880071...](这里在展示上,省略了一千五百多个维度的信息)
        document: Likes coffee
        metadata: {"_fusion_info": {"fts_rank": null, "rrf_score": 0.00819672131147541, "fts_weight": 0.5, "vector_rank": 1, "fusion_method": "rrf", "vector_weight": 0.5}, "search_count": 4, "last_searched_at": "2025-12-25T11:23:08.925772+08:00"}
         user_id: user123
        agent_id: NULL
          run_id: NULL
        actor_id:
            hash: 9b9c6ed72da0f1e8a3dfdbd8bdd11145
      created_at: 2025-12-25T10:44:30.171707+08:00
      updated_at: 2025-12-25T11:23:08.925744+08:00
        category:
fulltext_content: Likes coffee
1 row in set (0.02 sec)
最后,对 powermem 感兴趣的老师,欢迎阅读另外几篇和 powermem 有关公众号文章:
Hi,我是 OceanBase PowerMem,了解一下?
从开发者视角观察 OceanBase 开源的 AI 产品御三家
参考资料
[1] 轻量级接入方式: https://github.com/oceanbase/powermem/blob/main/docs/examples/scenario_1_basic_usage.md
[2] 记忆的智能提取: https://github.com/oceanbase/powermem/blob/main/docs/examples/scenario_2_intelligent_memory.md
[3] 艾宾浩斯遗忘曲线: https://github.com/oceanbase/powermem/blob/main/docs/examples/scenario_8_ebbinghaus_forgetting_curve.md
[4] 智能体共享/隔离记忆: https://github.com/oceanbase/powermem/blob/main/docs/examples/scenario_3_multi_agent.md
[5] 文本、图像、语音记忆: https://github.com/oceanbase/powermem/blob/main/docs/examples/scenario_7_multimodal.md
[6] 支持子存储(Sub Stores): https://github.com/oceanbase/powermem/blob/main/docs/examples/scenario_6_sub_stores.md
[7] 混合检索:
https://github.com/oceanbase/powermem/blob/main/docs/examples/scenario_2_intelligent_memory.md*
[8] PowerMem GitHub 仓库: GitHub - oceanbase/powercontext: Agent memory: long-term memory & agent memory handoff. Claude Code & Codex. · GitHub
[10] PowerMem 官方网站: https://www.powermem.ai/
[11] seekdb 官方网站: https://www.oceanbase.ai/