
【 使用环境 】测试环境
【 OB or 其他组件 】OCEANBASE
【 使用版本 】4.2.1.10 - 单副本部署 - 虚拟机环境
【问题描述】今天项目组反馈测试环境,OB数据库有问题。
1、 OCP查询到集群sys租户状态异常。
2、OCP查询到10月25日上午约8点50分告警disk hung。
3、手动连接sys租户,可以登上,执行sql语句超时。
4、主机查看observer进程还在,日志一直在刷disk hung
5、OCP查询自hung以来到今天的监控数据,可以看到主机的监控数据,sys租户和业务租户的监控数据都查询不到,也就是说自hung以后,服务大概率就都异常了。
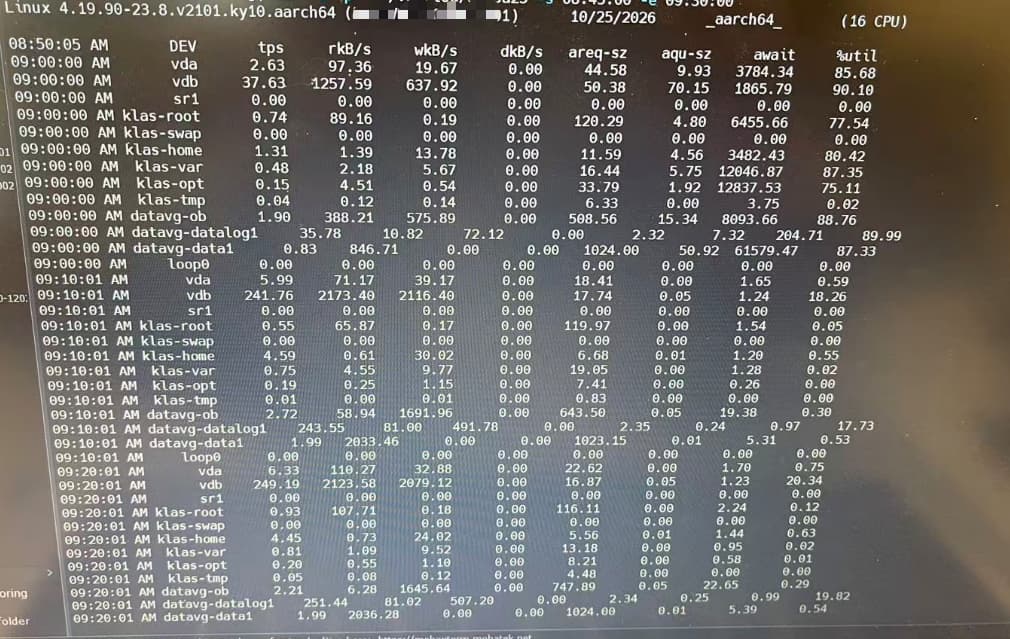
6、查看10月25日hung前后的IO等相关的数据如下:
下图中故障时间点,所有的disk都出现了繁忙:
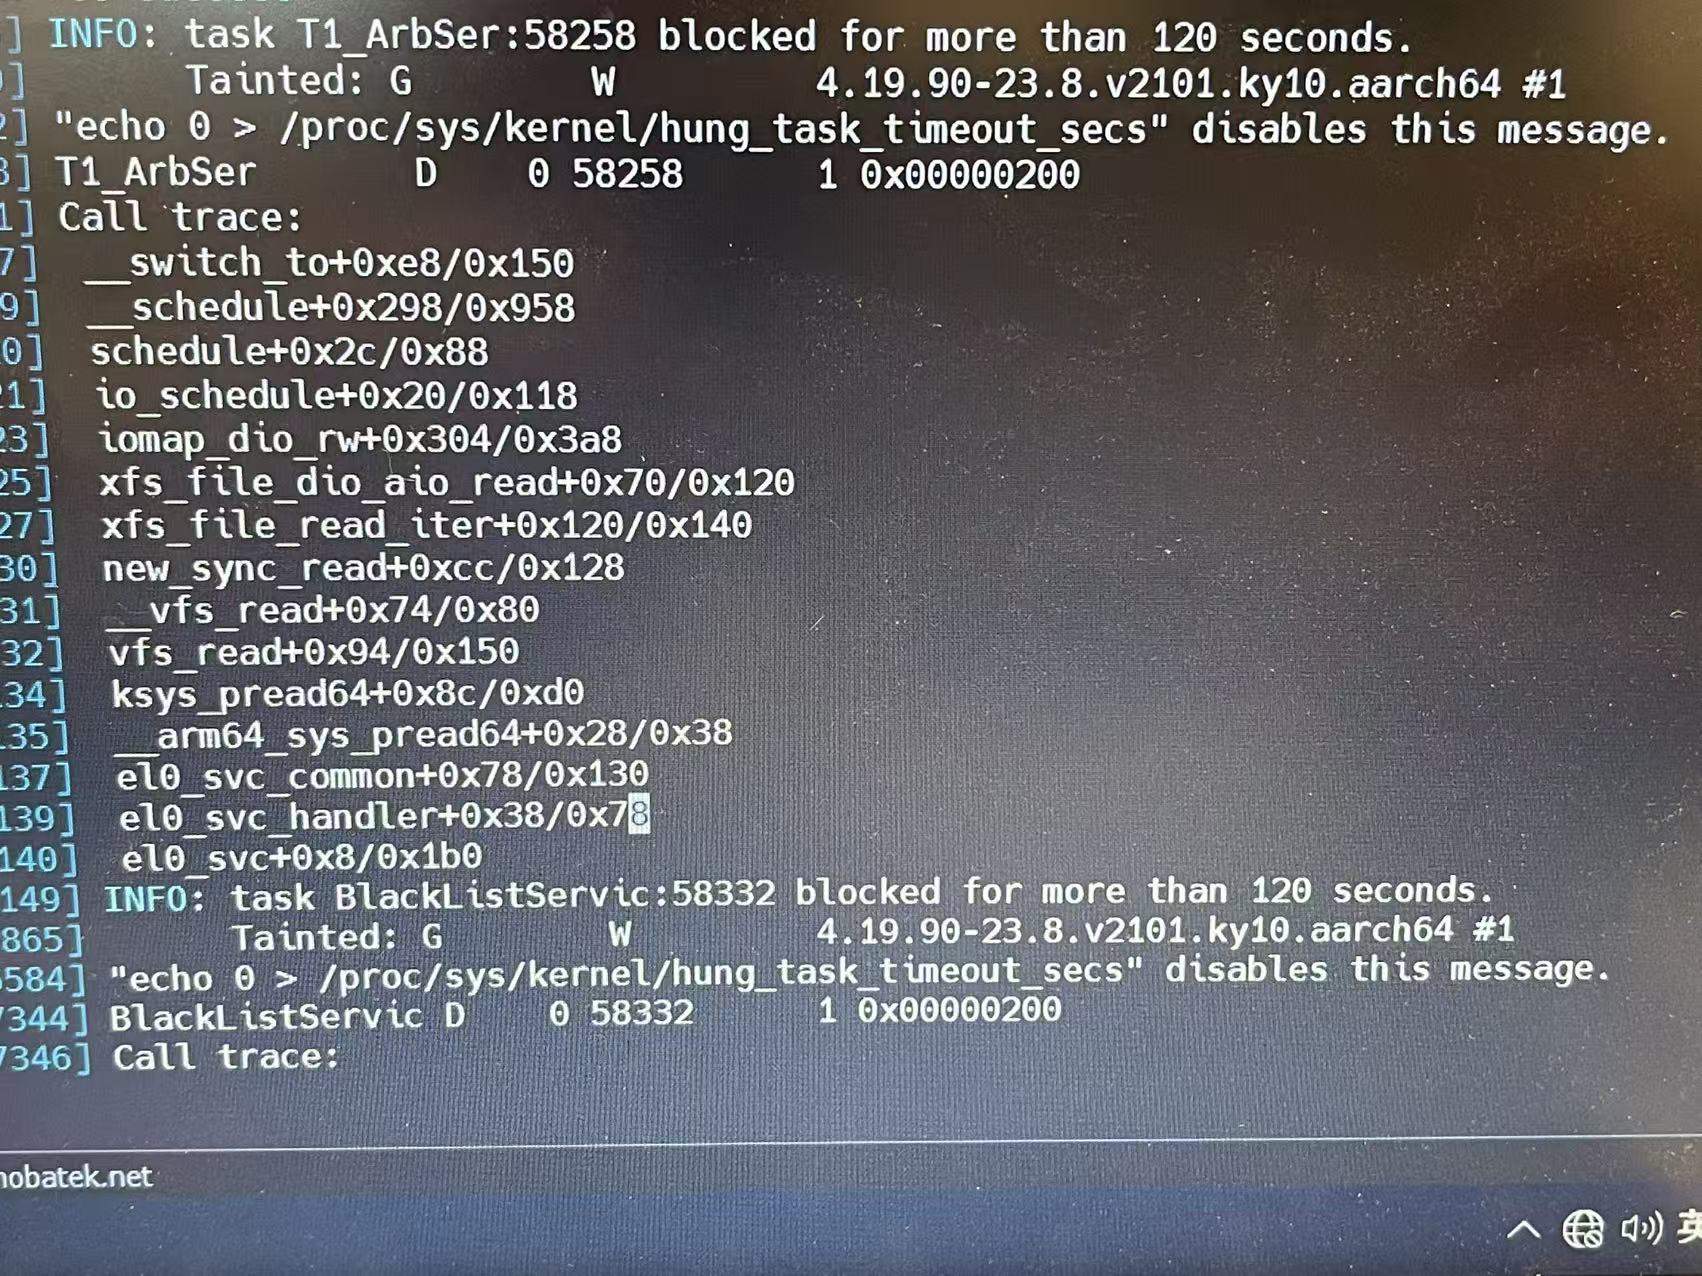
下图中故障时间点,可以看到一些OB的一些服务被block的信息:
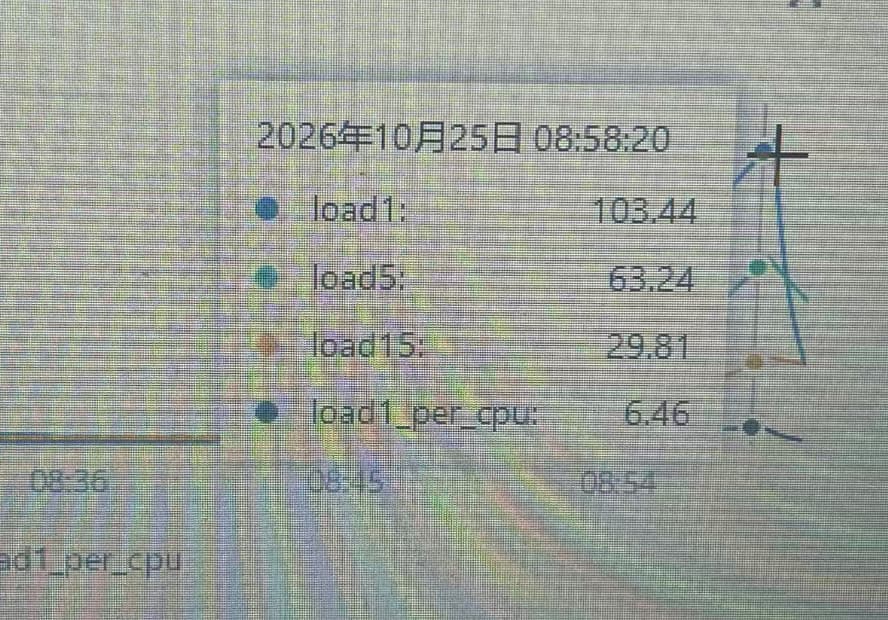
下图中故障时间点,可以看到服务器load负载较高:
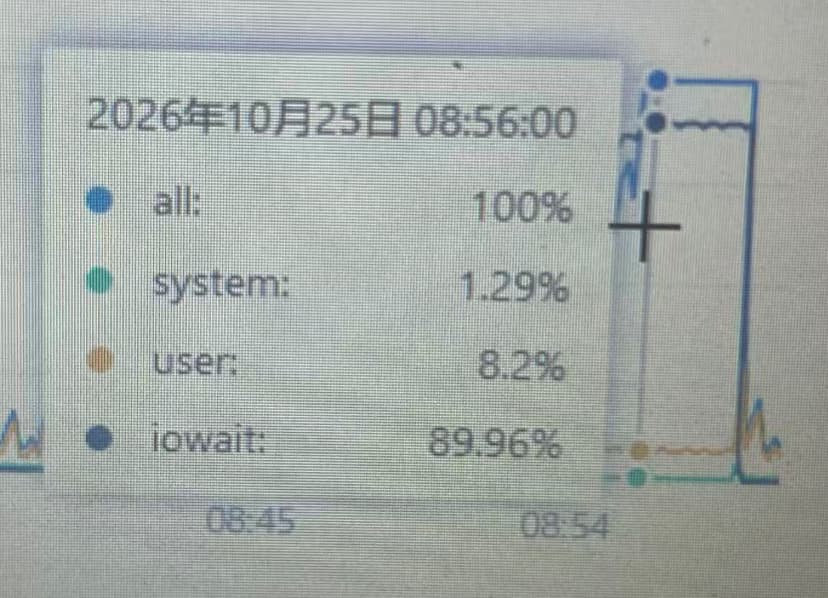
下图中故障时间点,可以看到服务器cpu io-wait较高:
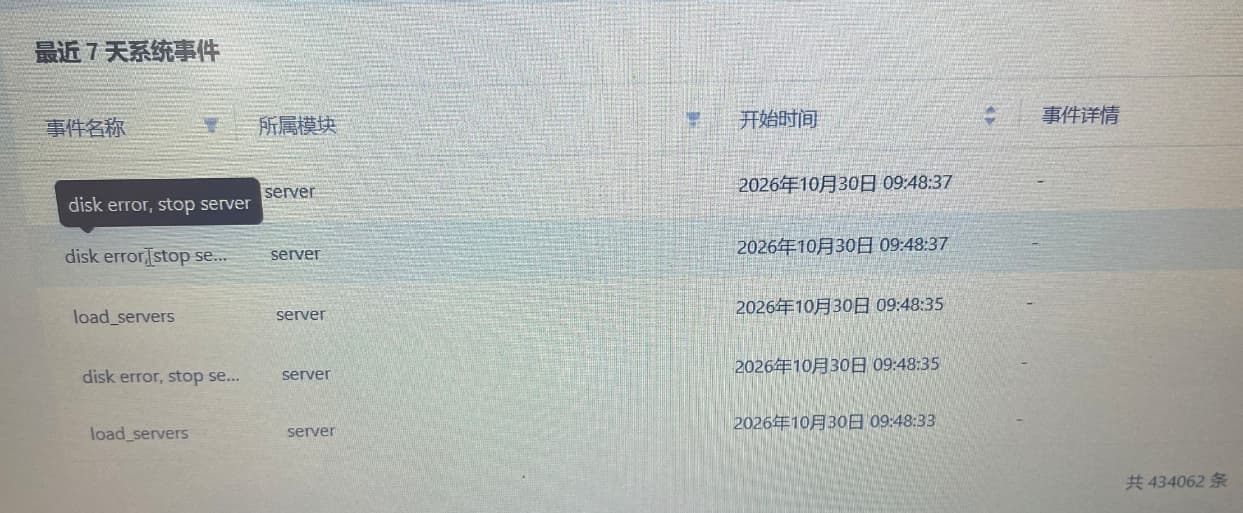
下图中故障时间点以来直到今天,一直反复报事件disk_error, stop server、load_servers:
结合以上信息,大致判断是因为虚拟机的磁盘短时间出现IO问题导致。不只数据盘,系统盘也是。
后来是重启了集群服务,恢复正常。
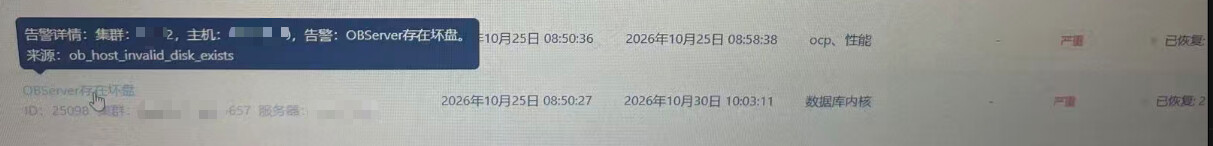
下图中告警在重启集群后恢复:
现在有几个疑问关于OB的原理问题请教下各位老师:
1、当hung之后,如果是多副本,会发生切主,本机会触发stop service。
2、当hung之后,如果是单副本,会发生stop service。
不知道理解的是否正确,从现象看,系统磁盘IO恢复正常后,ob服务并没有恢复。
还请各位老师解答一下。谢谢