
三个生产工单,三个已确认的内核缺陷:一个让查询结果悄悄少了一半,一个让 DROP 空表等了 40 秒,一个直接把进程 core 掉。
写在前面:先别怀疑自己用错了
数据库出问题时,DBA 的第一反应往往是「我 SQL 写错了 / 我姿势不对」。这三个案例最后都被官方定性为内核缺陷,跟使用方式无关。所以这篇想传递的第一个经验是:
当现象诡异到「不可能」的时候,先认真考虑它是 bug。
三个案例的诡异之处分别在于:
同一条 SQL,两个会话返回不同行数,而且各自稳定;
DROP 一张空表要 40 秒,且 sql_audit 显示等待在网络上;
一条普通的 COUNT 校验 SQL 让 observer 进程 core 掉。
下面逐个说。
案例一:同一条 SQL,两个会话返回了不同行数
现象
一条多层外连接的报表 SQL(WITH 多段 CTE + 多个 LEFT JOIN 派生表 + 结尾一个 NOT EXISTS 排除条件),在 A 会话执行返回 25 行,在 B 会话执行返回 52 行。换个会话有时 52、有时 25。
关键背景:这是测试环境,数据静止,没有任何并发写入。
排除法:不是数据在变,也不是旧快照
这类现象通常有四种解释:数据在变、会话读了旧快照、读的不是同一份数据、同一份数据走了不同执行计划。前两种可以当场证伪:
1.双会话交叉验证:A 窗口 25 → B 窗口 52 → 回到 A 仍是 25。两个会话各自稳定、互不影响,说明不是「某一瞬间数据被改了」。
2.提交事务前后各跑一次:在同一会话里 COMMIT 前后分别执行,结果都是 25;再用 GVOB_SQL_AUDIT 的 SNAPSHOT_VERSION、SNAPSHOT_SOURCE、TRANSACTION_HASH 三个字段核对,读快照来源与版本完全一致。会话停在旧读快照这个假设也排除。
剩下只有两种可能。逐字节比对两条语句的 QUERY_SQL(长度都是 6683 字符)、SQL_ID 相同、登录用户与租户相同 —— 语句文本这一层彻底排除,于是问题必然在执行计划上。
定位分叉点:同一个 SQL_ID,两个 PLAN_HASH
从 GVOB_SQL_AUDIT 里取两次执行的 PLAN_HASH:
返回 25 那次:PLAN_HASH 9479711821387333098,存储层扫描 396236 行
返回 52 那次:PLAN_HASH 7588877514654446452,存储层扫描 12626 行
这里有个容易踩的认知误区:「SQL_ID 只有一个」不能证明两次执行方式相同。同一个 SQL_ID 在不同节点上可以生成不同的 PLAN_HASH。 这两次执行恰好落在了集群的不同节点上。
两份计划逐层比对,表级估算行数一致、NOT EXISTS 段结构完全相同,唯一差异是返回 25 那份最外层多了一个 HASH_GROUP_BY 算子。
再往下就是优化器追踪(dbms_xplan.enable_opt_trace + set_opt_trace_parameter,level 3 才含 SQL 改写过程)。两份追踪记录里只有一个改写规则的选择不同:
| 采纳「分组上拉」 | 放弃「分组上拉」 | |
|---|---|---|
| 结果 | 25 行(错) | 52 行(对) |
| 代价变化 | 239926.87 → 237857.41(变便宜,故采纳) | 579913.25 → 1241826.52(变贵,故放弃) |
代价变化 239926.87 → 237857.41(变便宜,故采纳) 579913.25 → 1241826.52(变贵,故放弃)
也就是说,这个改写规则本身算错了代价,把一个错误的计划判成了更优的计划。
根因
官方定性(原文):属产品缺陷,根因是 SQL 优化器的查询重写模块(聚合上拉与视图合并规则)导致物理执行计划错误,进而造成结果集异常。
机理拆开是这样:
子查询里的 GROUP BY 被聚合上拉(GROUPBY_PULLUP)搬到外层,同时该子查询自己的 GROUP BY 被清空 → 它退化成一个纯连接结构;
紧接着视图合并(VIEW_MERGE)把这个子查询的表嵌进外层查询块;
两层改写叠加后,LEFT JOIN 的语义被破坏,行在 GROUP BY 之前就已经变少。
触发条件:
多层外连接场景,且外层 ON 条件里含引用右侧连接子树的过滤条件(形如 NVL(s.attrc,‘1’) <> ‘YY’)。连接重排后主表提前参与外连接,而该过滤条件延后作为连接结果的 post-filter 执行;当存在不满足过滤条件的右侧匹配记录时,本应保留并补 NULL 的主表记录被整体过滤掉,导致结果集缺行。
正确结果是 52 行,25 行是缺行后的错误结果。
影响版本 / 规避 / 修复状态
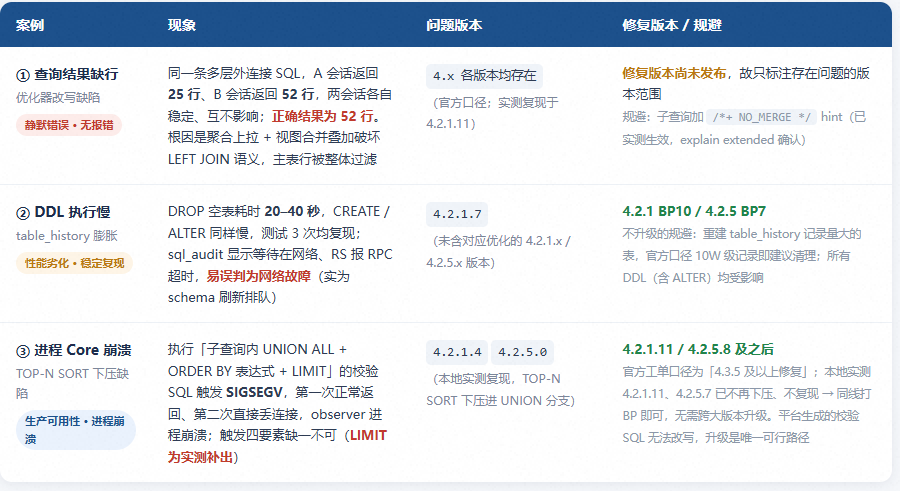
影响范围:官方答复 4.x 各版本均存在(本例复现于 4.2.1.11)。
规避方式(官方推荐,已实测生效):在子查询上加 /*+ NO_MERGE */ hint,并用 explain extended 确认 hint 生效。
修复状态:官方已确认修复计划,但截至本文写作,修复版本尚未发布。预计在4.2.1bp11hf21和425BP8hotfix2上进行修复,版本在11月份发布。。
自查:3 张表 7 行数据就能复现
这是官方给的最小复现脚本,也是判断「我这条 SQL 是不是同一个缺陷」最快的办法:
CREATE TABLE OB25_P (ID NUMBER PRIMARY KEY, BG_ID NUMBER);
CREATE TABLE OB25_M (MID NUMBER PRIMARY KEY, PID NUMBER, AMOUNT NUMBER);
CREATE TABLE OB25_S (BG_ID NUMBER PRIMARY KEY, ATTRC VARCHAR2(10));
INSERT INTO OB25_P VALUES (1, 10);
INSERT INTO OB25_P VALUES (2, 20);
INSERT INTO OB25_S VALUES (10, 'YY');
INSERT INTO OB25_S VALUES (20, 'ZZ');
INSERT INTO OB25_M VALUES (11, 1, 100);
INSERT INTO OB25_M VALUES (21, 2, 200);
INSERT INTO OB25_M VALUES (22, 2, 20);
-- 正确:2 行(ID 1 → 0,ID 2 → 220)
SELECT i.id, NVL(SUM(m.amount), 0) AS amt
FROM OB25_P i
LEFT JOIN ( (OB25_P p LEFT JOIN OB25_M m ON m.pid = p.id)
            LEFT JOIN OB25_S s ON s.bg_id = p.bg_id )
       ON p.id = i.id AND NVL(s.attrc, '1') <> 'YY'
GROUP BY i.id ORDER BY i.id;

-- 错误:仅 1 行(ID 2 → 220),主表 ID 1 被整体过滤掉
SELECT /*+ LEADING(((p s) i) m) */ i.id, NVL(SUM(m.amount), 0) AS amt
FROM OB25_P i
LEFT JOIN ( (OB25_P p LEFT JOIN OB25_M m ON m.pid = p.id)
            LEFT JOIN OB25_S s ON s.bg_id = p.bg_id )
       ON p.id = i.id AND NVL(s.attrc, '1') <> 'YY'
GROUP BY i.id ORDER BY i.id;
要点是用 LEADING 强制连接顺序,就能把错误形态稳定逼出来。这说明问题出在「改写 + 连接顺序」的组合上,与数据量、并发、读快照全都无关 —— 7 行数据就能触发。
顺带记几个坑
- GVOB_PLAN_CACHE_PLAN_EXPLAIN 取计划时,SVR_IP / SVR_PORT / TENANT_ID / PLAN_ID 四个条件必须等值且取自同一次执行,写成 IN 或漏一个都查不到;计划被淘汰时返回空行,需重新执行取新 PLAN_ID。
- Oracle 模式下该视图的 NAME、ROWS 是关键字,反引号写法不被接受,改用 SELECT * 或双引号标识符。
- 优化器追踪文件落在会话实际所在节点的 observer log 目录,从开启到关闭之间不要执行其他 SQL;并且如果已经有计划缓存,不会生成trace文件,可以清空下plan cache。
- 还有一句提醒:ODC 的结果集导出是重新执行 SQL,导出文件的行数反映导出那一刻的读取结果,不是你在窗口里那次的快照。别拿导出行数当证据。
案例二:DROP 一张空表,等了 40 秒
现象
业务执行 DROP TABLE(删的是空表)稳定慢,单条要 20s、40s 才完成;CREATE 也慢。测试 3 次均复现。同集群其他租户无反馈,当天无 unit 扩容、无 unit 迁移、无 observer 重启。
排查中最大的方向纠偏:RPC 超时 ≠ 网络故障
这条工单在 4 天里换了四次方向,值得单独说:
schema 刷新失败 → 怀疑并行高频 truncate → 怀疑节点负载(tsar 看 cpu/mem/traffic/tcp,全正常)→ 怀疑网络(因为 sql_audit 显示等待在网络上、RS 日志报 RPC 通信超 2s)→ 最后才回到真相。
在官方给出「节点间通信有问题」的阶段性结论之后,追问了一句「那和之前查的 RPC 超时还有关系吗」。官方随即明确:
RPC 超时是因为这些表被频繁操作,导致 RPC 去刷新 schema 失败。
也就是说,DDL 慢 + RPC 超时 + sql_audit 显示等待在网络,这三件事同时出现时,先查 table_history,别先查网络。 而 tsar 各项指标正常本身就已经在暗示这不是网络问题了 —— 只是当时没人把它和 RPC 超时串起来。
真正定位根因的两步
**第一步:**看 DDL 到底堵在哪。 抓 obstack(4.x ARM 版 /home/admin/oceanbase/bin 自带,./obstack observer pid > xx.trc),从 rs.log 里找到执行该 DDL 的线程号,再看这个线程当时还在做什么:
[13485][DDLQueueTh0] lock_table (ob_ddl_service.cpp:5479)
同一个线程此刻还在刷 schema、建索引。4.x 是共用 DDL 线程,于是「drop 慢」被解释成了串行 DDL 线程排队。
**第二步:**看谁把线程占住的。
SELECT tenant_id, table_id, table_name, COUNT(*)
FROM __all_virtual_table_history
GROUP BY 1,2,3 ORDER BY COUNT(*) DESC LIMIT 20;
结果一目了然:某几张表的 history 记录数异常膨胀。
根因
官方结论(原文逻辑):
SQL 慢是慢在 schema 刷新慢;
该版本 TRUNCATE 的实现有问题 —— truncate 需要读 table_history 表,而被 truncate 的表在 table_history 里的记录不会被清理,只有把这张表 drop 掉才能刷掉;
于是 truncate 用得越多,这张表记录越堆越多,后续所有 DDL 都要为它排队。
这里有个必须记住的对比:__all_virtual_table_history 里,drop 掉的表记录会自动清理,truncate 的记录只累加。 所以这张表会随时间单调膨胀,长期只有重建才能压下去。
影响版本 / 规避 / 修复
修复版本:4.2.1 BP10,4.2.5 BP7(该版本让 truncate 执行过程中 schema 刷新速度不再太受 table_history 数量影响)。我的问题是出现在 4.2.1.7。
不升级的规避:对记录量大的表做 DROP + CREATE 重建。官方给的清理阈值口径是「10W 级别的记录都要清理下」。
适用范围:不只 DROP,ALTER 等所有 DDL 都存在该问题(官方明确「只要是 DDL 都存在这个问题」)。
案例三:进程直接 Core
现象
生产环境 observer 进程 core。CRASH ERROR 关键字段:
sig=11 (SIGSEGV)   IP=ffffffffffffffff   RBP=ffffffffffffffff
sig_code=1         lbt=(空,崩溃栈未落盘)
tname=T1002_L0_G0  tid=960657
触发 SQL 长这样:
SELECT COUNT(1) cnt
FROM (
  SELECT ... FROM ... UNION ALL SELECT ... FROM ...
  ORDER BY province_code = '10' LIMIT 1000
) t;
根因
关单小结原文:
此问题是当同一个子查询里同时包括 UNION 和 ORDER BY + 表达式触发的内核缺陷。低版本为了解决 sort 算子不能有共享子表达式的问题,强制把 sort 算子的表达式下压到子节点计算,但下压后 union 算子会 core 掉。
触发条件比官方描述多一个:必须有 LIMIT
官方给的三个要素是「同一子查询内 + UNION 与 ORDER BY + ORDER BY 的是表达式」。我自己搭了个最小复现,测出来还差一个必要条件:必须有 LIMIT。
CREATE TABLE test_source_a (user_id VARCHAR(50), cnt INT);
CREATE TABLE test_source_b (user_id VARCHAR(50), cnt INT);
INSERT INTO test_source_a VALUES ('user_001', 10), ('user_002', 20);
INSERT INTO test_source_b VALUES ('user_003', 30), ('user_004', 40);
不带 LIMIT —— 计划里根本没有 TOP-N SORT,不下压,正常执行:
0  SCALAR GROUP BY                     1

1  └─SUBPLAN SCAN        t             4

2    └─UNION ALL                       4

3      ├─TABLE FULL SCAN test_source_a 2

4      └─TABLE FULL SCAN test_source_b 2
带上 LIMIT —— TOP-N SORT 出现,并且被下压进了 UNION ALL 的每个分支(ID 4、ID 6 两处):
0  SCALAR GROUP BY                         1

1  └─SUBPLAN SCAN            t             4

2    └─TOP-N SORT                          4

3      └─UNION ALL                         4

|4 |      ├─TOP-N SORT       |             |2       |   ← 下压进了分支
5        │ └─TABLE FULL SCAN test_source_a 2

|6 |      └─TOP-N SORT       |             |2       |   ← 下压进了分支
7          └─TABLE FULL SCAN test_source_b 2
执行结果是先正常返回一次,紧接着连接丢失、进程 core:
obclient> SELECT COUNT(1) cnt FROM ( ... ORDER BY user_id <> 'user_001', cnt DESC LIMIT 1000 ) t;
+------+
cnt

+------+
4

+------+
1 row in set

obclient> <同一条语句再执行一次>
ERROR 2013 (HY000): Lost connection to MySQL server during query
所以准确的触发条件是四要素:同一子查询内 + UNION ALL + ORDER BY 表达式 + LIMIT。TOP-N SORT 被下压到 UNION ALL 各分支这一步才是致命动作。
工单里工程师后来反馈新版本已经修复。我拿本地环境把两条线都验了一遍:
版本 TOP-N SORT 是否下压进 UNION 分支 是否 core
| 版本 | TOP-N SORT 是否下压进 UNION 分支 | 是否 core |
|---|---|---|
| 4.2.1.4 | 下压 | core(第二次执行丢连接) |
| 4.2.5.0 | 下压 | core(第二次执行丢连接) |
| 4.2.1.11 | 不再下压 | 不复现 |
| 4.2.5.7 | 不再下压 | 不复现 |
修复后的计划里,TOP-N SORT 与 UNION ALL 之间多了一层 SUBPLAN SCAN (VIEW1) 作为屏障,下压被挡住了:
0  SCALAR GROUP BY                         1

1  └─SUBPLAN SCAN            t             4

2    └─TOP-N SORT                          4

|3 |    └─SUBPLAN SCAN       |VIEW1        |4       |   ← 新增的屏障
4        └─UNION ALL                       4

5          ├─TABLE FULL SCAN test_source_a 2

6          └─TABLE FULL SCAN test_source_b 2
结论:
这个缺陷已经修复,4.2.1 线内打到 4.2.1.11、4.2.5 线内打到 4.2.5.7 及之后版本即可修复(其中 4.2.1.11 与 4.2.5.7 经本地复现验证)。
三个案例总结
附:说明
本文的缺陷定性与修复版本信息来自 OceanBase 官方工单沟通结论,案例三的修复版本另经本地环境复现验证。
三个案例的根因描述均为官方结论的转述,机理部分为便于理解做的展开,如与官方后续说明不一致,以官方为准。