李努力
#1
2-2-2 ob集群,3个zone,每个zone中2个unit,primary zone=3,均为全能型副本
那应该就是总共有6个日志流,每个日志流3个副本
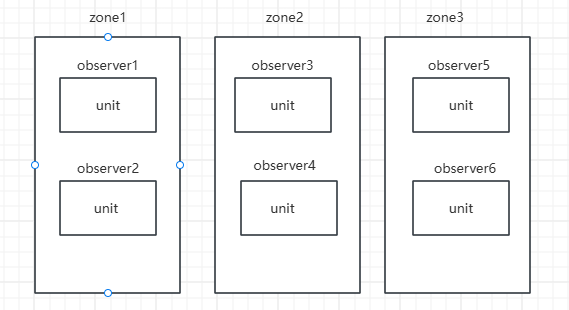
如图这种情况下:
类似情况1:某个zone observer全宕机,例如 zone3中的两个observer5和observer6宕机
类似情况2:随机两个zone中各宕机一台observer,例如,zone1中observer1宕机、zone2中observer4宕机
类似情况3:每个zone中宕机一台observer,例如 observer2、observer3、observer6宕机
类似情况4:某个zone observer全宕机,外加某个zone中某台observer宕机,例如 zone2中的oberver3、observer4均宕机,另外zone1中的observer1也宕机
对于情况1:大多数副本存在,能正常提供服务,添加新机器后会自动均衡副本
对于情况2:部分表的分片不能提供服务(恰好表的某个分片多数副本落在了宕机的observer上)
对于情况3:和情况2类似,部分表的分片不能提供服务(恰好表的某个分片多数副本落在了宕机的observer上)
对于情况4:和情况2、3类似,部分表的分片不能提供服务,只有分片在存活的observer上的才能提供服务
对于这块不大懂,不知分析的对不对
李努力
#4
有几个疑问,老师
1、日志流的个数,不是由unit_num * primary zone决定的吗?那是不是就预估不了了,但是至少是6个吧?除了系统日志流
2、假如说2这种情况,恰好有个表的部分分片,大多数落在了宕机的observer上:
① 如果能把宕机的observer恢复且数据不丢是不是就能整体恢复
② 如果机器恢复不了的话直接换了新的机器,由于部分分片丢失了大多数,所以也不会选主,自然也不会恢复,也会处于部分分片不可用的状态
3、同一个zone中的不同observer之间,比如有一个宕机了,他们之间不会相互承载对方的分片吗?
淇铭
#5
1、 用户日志流数 = UNIT_NUM × PRIMARY_ZONE 第一优先级 Zone 数 是这样计算但是
按照你给的图 unit_num=2、primary_zone 三区同级 → 用户 LS = 2 × 3 = 6,可以预估,不是猜的。
2、(如 obs1 + obs4)在正常同构 Unit Group 配对下,两台挂的往往是不同 Unit Group,每个 LS 只丢 1 副本,一般仍是 2/3,整库可服务。
按照已经丢多数派来答你的 ①②:
1) 原机恢复且数据还在
对,整体可以恢复。
2)机器彻底换新(盘也没了)
差不多这个意思:只换机、空等自动均衡,丢多数派的 LS 通常不会自己好。
3、不会事先互备,同 zone 另一台是并列的另一组数据,不是同组数据的备机
李努力
#6
就是说,如果一个表有4个分区,每个分区以及副本分布的位置和unit group相关,副本都在同一个unit group中,只要该unit group中保持大多数,整体就能提供服务