
ob集群(ocp平台操作),六台物理机,每两台在一个zone中,每个zone两个unit
现在zone2中有A、B两台机器,B物理机硬盘有坏块,导致B物理机上的observer启动失败
现在需要增加一台新的C物理机来替换损坏的B物理机
是直接在B主机observer处点击替换,还是先在zone2中添加新的C observer,然后在observer处再删除损坏的B物理机呢?
两种方式对于这种物理机损坏,导致observer起不来的情况,有什么区别呢

替换故障 OBServer 节点的步骤及两种方式的区别
根据您描述的情况,即在 OceanBase 集群中替换一台损坏的 OBServer 节点(此处为 B 物理机),可以通过 OCP 平台来操作。对于如何执行这一替换过程以及不同方法之间存在的差异,基于文档提供的信息,下面是对您问题的解答。
一、替换流程建议
针对您的场景——需要增加一台新的 C 物理机来替换损坏了硬盘且 observer 无法启动的 B 物理机,推荐先添加新节点再移除旧节点的方式。具体步骤如下:
- 登录OCP 并进入集群管理界面。
- 在 OCP 的 集群列表 中选择要操作的目标集群,并进入其详情页。
- 前往 OBServer列表 页面。
- 在该页面上找到对应的 zone2 区域。
-
新增C物理机上的observer实例 至当前集群和指定zone2。
- 这一步通过点击界面上相应的“新增”或“添加”按钮实现。
- 等待新添加的C节点状态稳定后 ,再进行下一步操作。
-
停止并删除B节点上的observer进程:
- 选择已经确认无法正常工作的 B 物理机上的 observer 实例。
- 执行停止进程的操作。
- 确认停止成功之后,在界面上执行删除此 observer 的命令。
这样做的好处是可以保证整个集群在过渡期间仍保持高可用性,同时确保数据的一致性和完整性不受影响。
二、直接替换与先加后删的区别
-
直接替换法:若直接尝试在 OCP 中对 B 节点使用“替换”功能,则可能面临以下风险或局限性:
- 如果目标替换位置(即C机器)尚未完全准备好或者配置不当,可能会导致短暂的数据访问不稳定甚至中断。
- 此外,当原节点处于不可用状态时,直接替换可能因为缺乏正确的通信路径而难以顺利完成。
-
先增加再删除法:按照上述推荐步骤操作的话,能够更好地控制替换过程中的风险:
- 新增节点可以作为一个缓冲区,确保在处理旧有问题节点前已经有替代方案就位。
- 当新增节点加入后且状态良好,再去处理原有的问题节点,可最大程度地减少服务中断的可能性。
- 更重要的是,这种方法符合OceanBase官方文档推荐的最佳实践指南,如运维最佳实践/OceanBase 集群主机故障处理中所述。
总之,在您的特定情况下,采用先向 Zone2 添加新节点然后安全地移除故障节点的方法是更为稳健的选择。这不仅遵循了OceanBase推荐的安全操作原则,而且有助于保障业务连续性和集群稳定性。
更多信息请查看:
老师,那如果C替换B替换完成了,当B修好后,维修时间比较短,想把B再替换回来,那如果此时C上还在数据均衡,能直接替换为B吗?还是必须等C均衡完了才能替换成B ?
建议C均衡完在搞
1 个赞
那如何查看是否均衡完了呢?若一直有数据写入呢
ob是哪个版本呢
– 1. OCP 上先看任务
- 任务中心:替换任务状态为 完成
- OBServer 列表:C 为 运行中,B 已从列表消失(或已下线)
- 资源管理 → Unit 分布:zone2 上原 B 的 Unit 已落在 A/C,没有“迁移中”标记
– 2. 库内确认是否真正迁完(推荐)
连 oceanbase 租户执行:
-- 1) 是否还有 Unit 在迁(为空 = Unit 迁移结束)
SELECT unit_id,
       CONCAT(migrate_from_svr_ip, ':', migrate_from_svr_port) AS src,
       CONCAT(svr_ip, ':', svr_port) AS dst
FROM oceanbase.DBA_OB_UNITS
WHERE migrate_from_svr_ip IS NOT NULL;

-- 2) Unit 迁移任务(为空或无 INPROGRESS = 完成)
SELECT * FROM oceanbase.DBA_OB_UNIT_JOBS
WHERE JOB_TYPE = 'MIGRATE_UNIT';

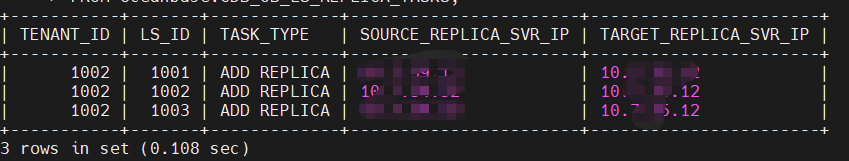
-- 3) 正在跑的副本迁移任务(为空 = 当前无在途副本迁移)
SELECT TENANT_ID, LS_ID, TASK_TYPE,
       SOURCE_REPLICA_SVR_IP, TARGET_REPLICA_SVR_IP
FROM oceanbase.CDB_OB_LS_REPLICA_TASKS;

-- 4) 计划中的副本任务(为空 = 没有待调度迁移)
SELECT * FROM oceanbase.V$OB_LS_REPLICA_TASK_PLAN;

-- 5) 确认 B 上已无 Unit
SELECT * FROM oceanbase.DBA_OB_UNITS
WHERE SVR_IP = '<B的IP>';

-- 6) C 上 Unit 正常、节点 ACTIVE
SELECT SVR_IP, ZONE, STATUS, START_SERVICE_TIME
FROM oceanbase.DBA_OB_SERVERS
WHERE SVR_IP IN ('<A的IP>', '<C的IP>');
- 在 OCP 主机里把新物理机 C 纳管进来(同机房、同硬件架构,规格 ≥ B,与集群时钟差 ≤ 10ms)。
- 集群 → OBServer 列表 → 对故障节点 B 点 替换,选中 C。
- 因 B 已故障/离线,提示是否跳过主机运维时选 是。
- 等任务完成、C 上 observer 为 运行中 后,再在主机列表里 强制删除 离线的 B。