
问题现象:
集群版本:4.2.5.6
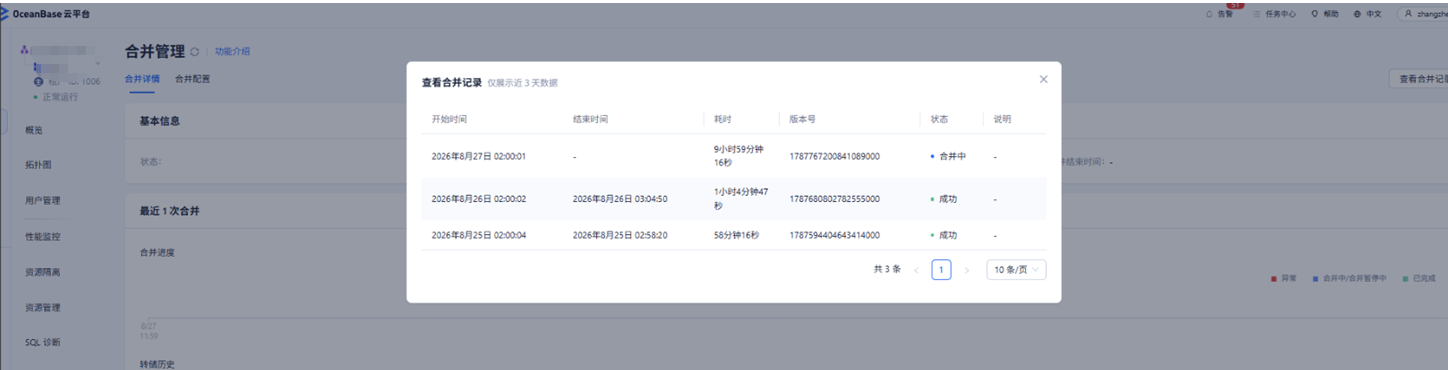
租户合并长时间未完成,合并进度无推进
跟进分析:
第一步: 确认该租户的合并信息
select * from CDB_OB_MAJOR_COMPACTION where tenant_id=1006;

status:COMPACTING 正在合并中
IS_ERROR:NO IS_SUSPENDED:NO 没有暂停合并,合并过程没有报错
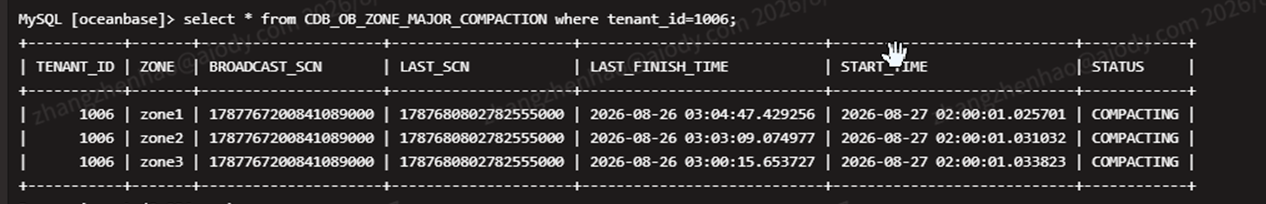
第二步: 再确认每个zone上的合并状态,三个zone均未合并成功。
select * from CDB_OB_ZONE_MAJOR_COMPACTION where tenant_id=1006;
第三步: 当前租户server 级别的合并情况
select * from GV$OB_COMPACTION_PROGRESS where tenant_id=1006 order by start_time desc limit 20;
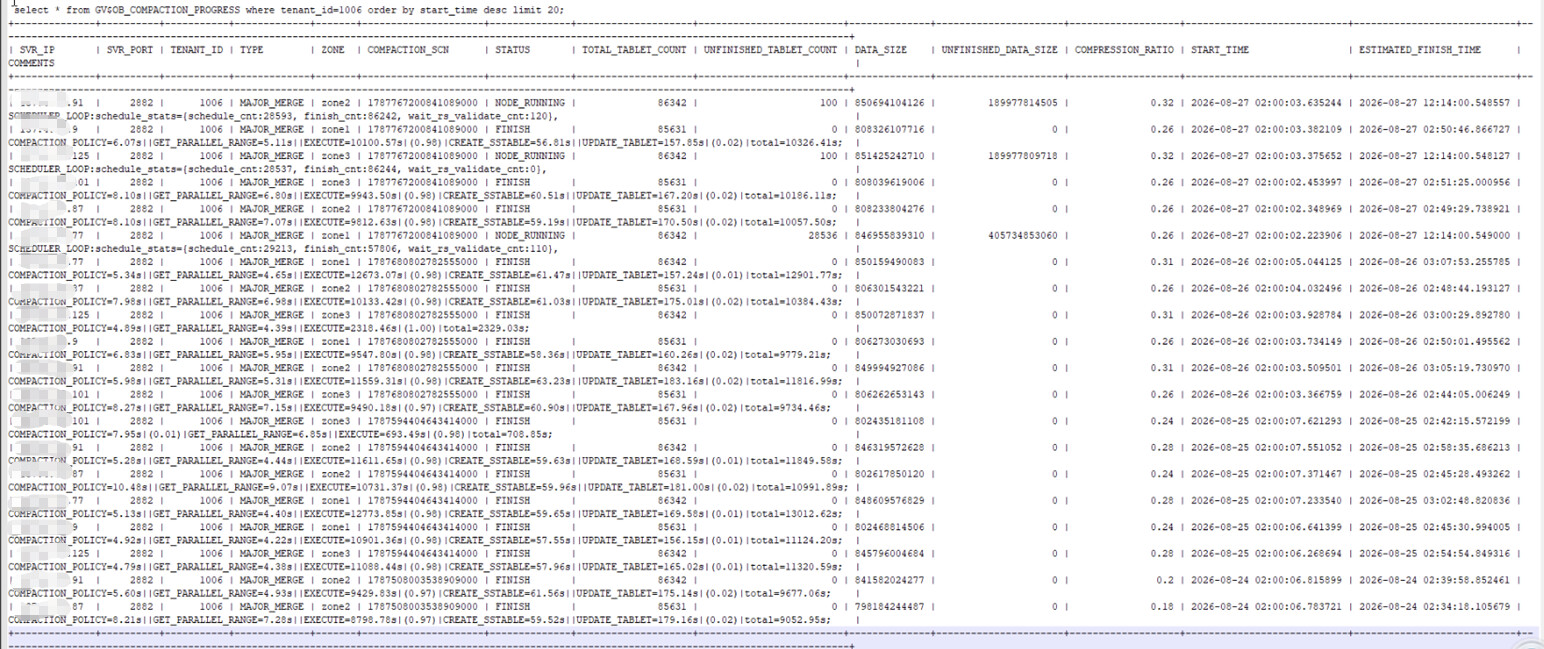
91,125,77节点STATUS为 NODE_RUNNING,UNFINISHED_TABLET_COUNT存在未合并完成的tablet且无变化,判断合并卡住
查询未完成合并的tablet个数
SELECT a.svr_ip,a.svr_port, COUNT(*) AS pending_tablet_count
FROM oceanbase.__all_virtual_tablet_meta_table a JOIN oceanbase.CDB_OB_MAJOR_COMPACTION b ON a.tenant_id = b.TENANT_ID
WHERE a.compaction_scn < b.GLOBAL_BROADCAST_SCN
GROUP BY a.svr_ip, a.svr_port
ORDER BY pending_tablet_count DESC;
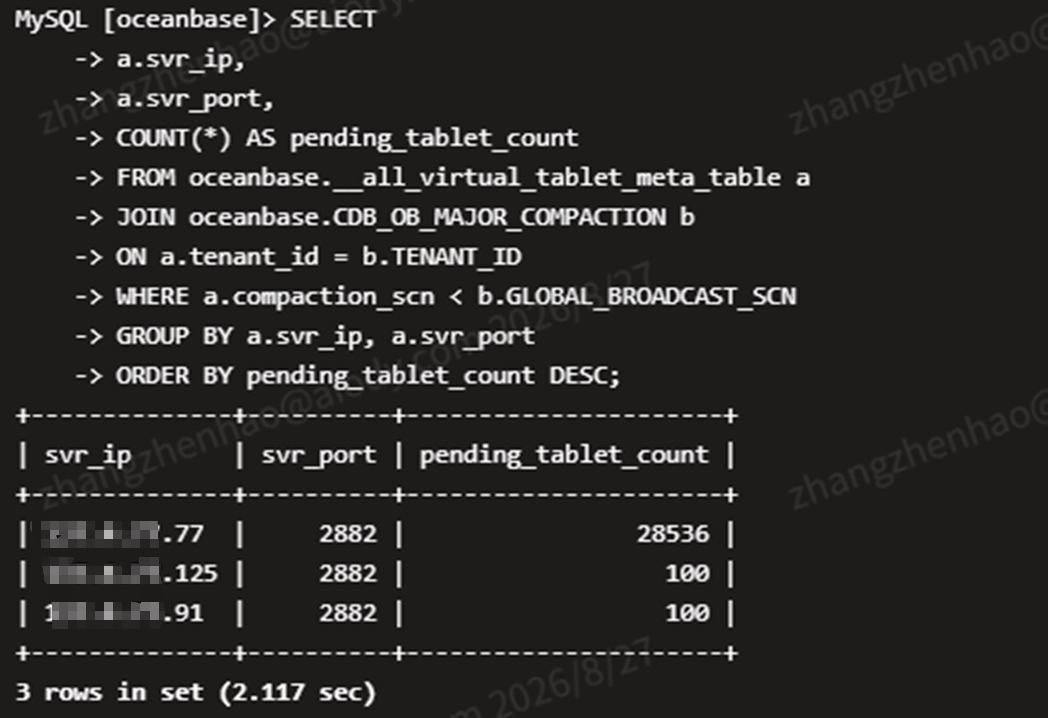
和GV$OB_COMPACTION_PROGRESS 中UNFINISHED_TABLET_COUNT值一致,确认这三个节点合并有问题
第四步: 查下当前租户的合并诊断视图
select * from GV$OB_COMPACTION_DIAGNOSE_INFO;
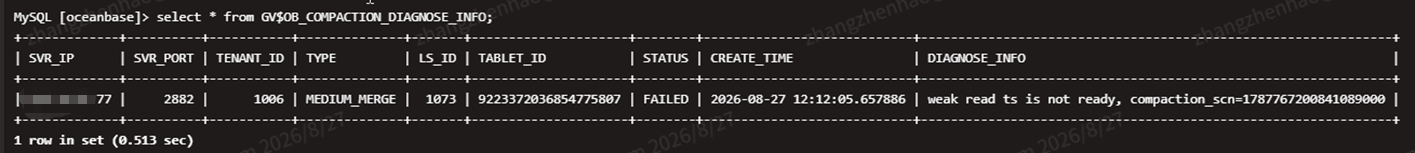
DIAGNOSE_INFO 显示 weak red ts is not ready, compaction scn-178776720084108900
初步判断为弱读时间戳(follower 副本)过于落后导致合并卡住,排查日志流
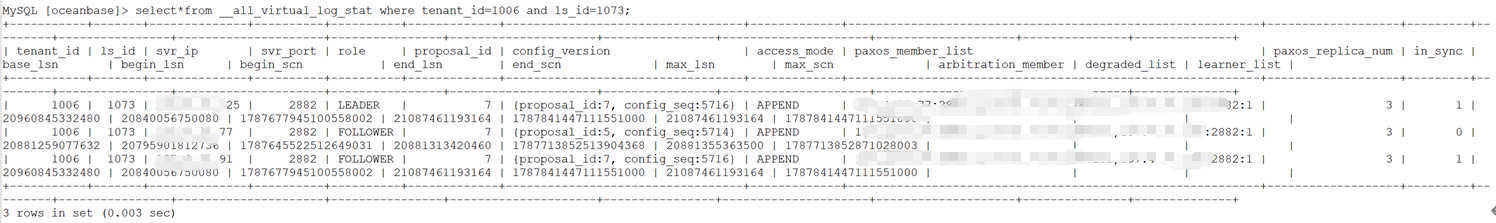
查看日志流
select * FROM oceanbase.GV$OB_LOG_STAT where TENANT_ID=1006;
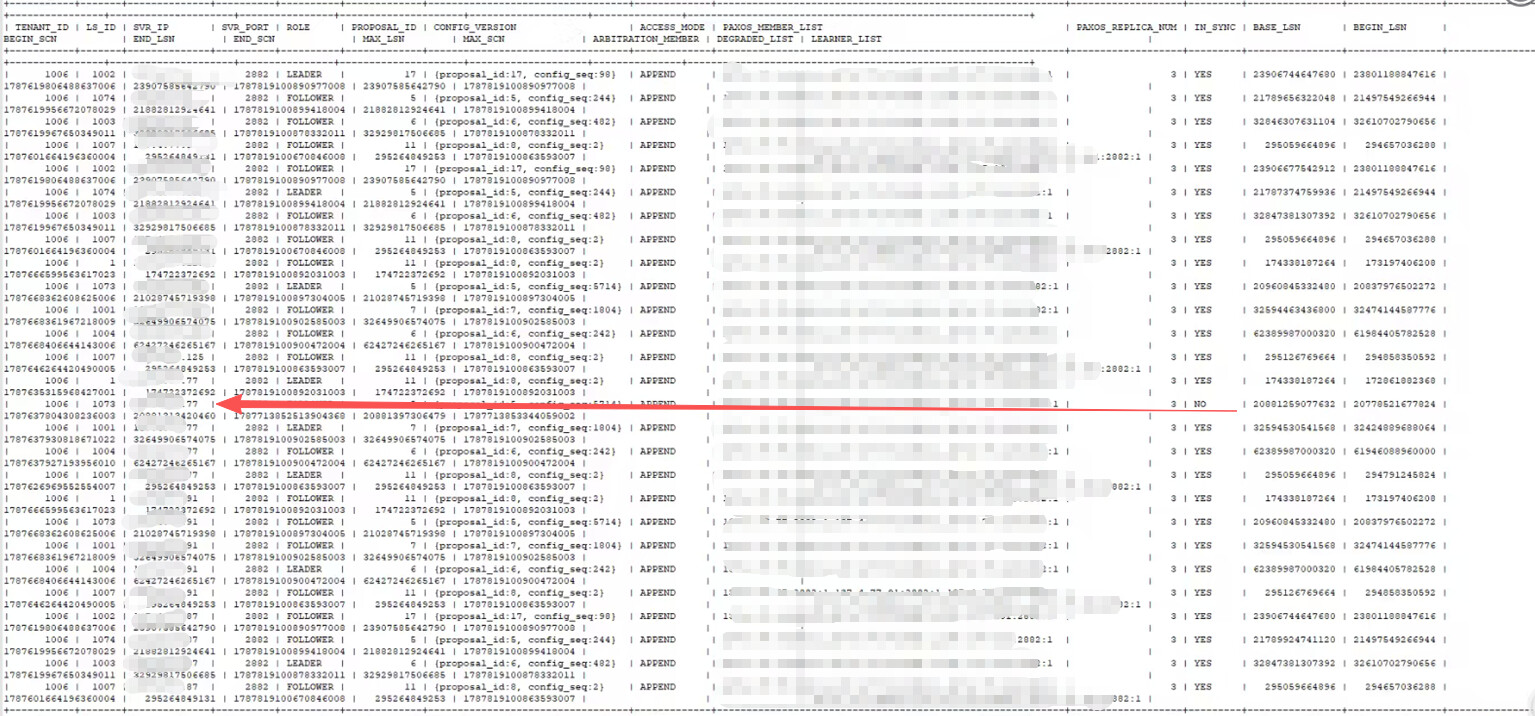
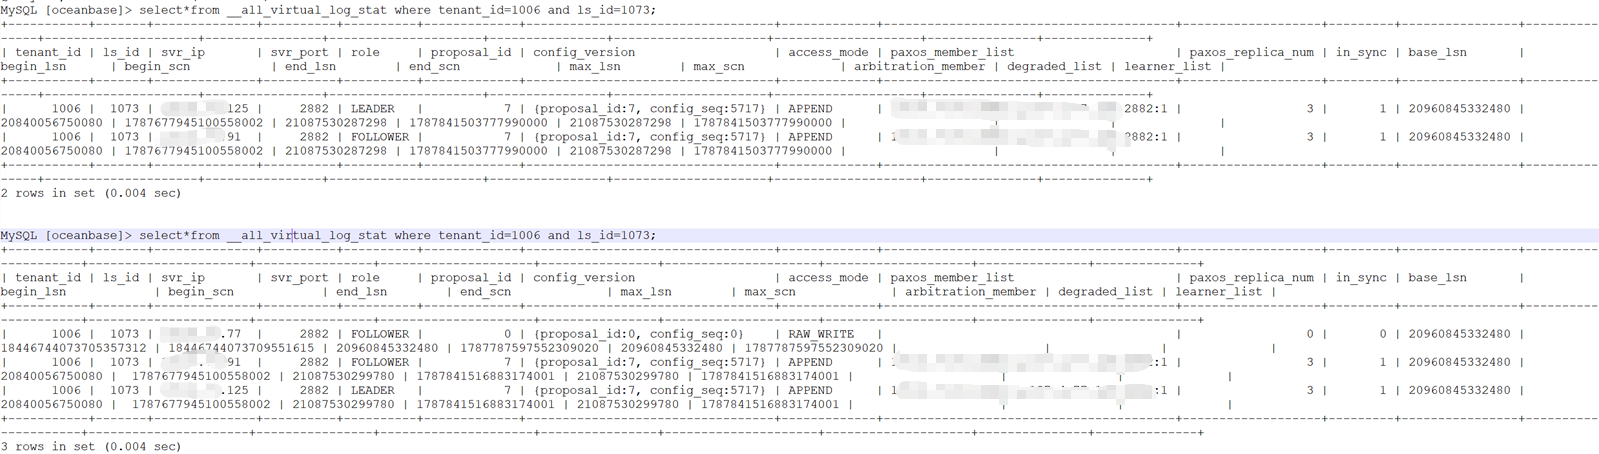
1073 日志流77 节点,IN_SYNC 为 NO,follower 副本未与leader 主副本 完全同步
过滤日志目前leader,125节点到达到了40M,不符合预期,leader副本available_buffer_size正常应是32M
grep 'PALF.DUMP' observer.log | grep 'available_buffer_size:41943040' | grep 'LEADER' | sed -nE 's/.*\[T([0-9]+)\].*palf_id[=:]([0-9]+).*/tenant_id=\1 palf_id=\2/p' | sort -u
available_buffer_size是 PALF 日志滑动窗口,可以理解为一个固定大小的日志缓冲区,leader预期只能写32M,所有新写入的日志先进入这个窗口,40M表示1073日志流在77节点已经被写满,无法再继续写,没有办法再继续同步日志,需要先将该节点的切主,恢复available_buffer_size为32M
处置步骤:
- 先通过日志流找到leader节点检查状态
通过以下语句找到日志流leader是否达到40M
grep 'PALF.DUMP' /home/admin/oceanbase/log/observer.log | grep 'available_buffer_size:41943040' | grep 'LEADER' | sed -nE 's/.*\[T([0-9]+)\].*palf_id[=:]([0-9]+).*/tenant_id=\1 palf_id=\2/p' | sort -u
-
如果达到40M说明该日志流需要进行处理
-
对该日志流进行切主操作
alter system switch replica leader ls = 1074 server = '1xx.x.xx.xx:2882' tenant = 'xxx';  --日志流切主
alter system switch replica default ls = 1074 server = '1xx.x.xx.xx1:2882' tenant = 'xxx'; --恢复操作
- 通过日志进行检查是否恢复
grep ‘PALF.DUMP’ /home/admin/oceanbase/log/observer.log grep T1006 grep ‘palf_id=1003’ tail -n 2
[2026-08-27 22:20:52.970626] INFO [PALF] check_and_switch_state (palf_handle_impl.cpp:2776) [86926][T1006_LogLoop][T1006][Y0-0000000000000000-0-0] [lt=1] [PALF_DUMP](palf_id=1004, self=“xxx.xx.xx.xx:2882”, [SlidingWindow]={palf_id:1004, self:“xxx.xx.xx.xx:2882”, lsn_allocator:{max_log_id:1787923265, max_lsn:62445521104481, max_scn:{val:1787840452805087002, v:0}}, group_buffer:{log_group_buffer: start_lsn:{lsn:7640184642021}, reuse_lsn:{lsn:62445521104481}, reserved_buffer_size:41943040, available_buffer_size:33554432, readable_begin_lsn:{lsn:62445479161441}}, last_submit_lsn:{lsn:62445521104315}, last_submit_end_lsn:{lsn:62445521104481}, last_submit_log_id:1787923265, last_submit_log_pid:10, max_flushed_lsn:{lsn:62445521104315}, max_flushed_end_lsn:{lsn:62445521104481}, max_flushed_log_pid:10, committed_end_lsn:{lsn:62445521104481}, last_slide_log_id:1787923265, last_slide_scn:{val:1787840452805087002, v:0}, last_slide_lsn:{lsn:62445521104315}, last_slide_end_lsn:{lsn:62445521104481}, last_slide_log_pid:10, last_slide_log_accum_checksum:2333878466, last_fetch_end_lsn:{lsn:18446744073709551615}, last_fetch_max_log_id:-1, last_fetch_committed_end_lsn:{lsn:18446744073709551615}, last_truncate_lsn:{lsn:18446744073709551615}, last_fetch_req_time:0, is_truncating:false, is_rebuilding:false, last_rebuild_lsn:{lsn:18446744073709551615}, freeze_mode:“FEEDBACK_FREEZE_MODE”, has_pending_handle_submit_task:false, last_fetch_trigger_type:“LOG_LOOP_TH”, this:0xfffade7b8630}, [StateMgr]={this:0xfffade7bdab0, self:“xxx.xx.xx.xx:2882”, palf_id:1004, role:“LEADER”, replica_type:“NORMAL_REPLICA”, state:“ACTIVE”, prepare_meta:{version:1, voted_for:“0.0.0.0:0”, log_proposal_id:10}, leader:“xxx.xx.xx.xx:2882”, leader_epoch:4, is_sync_enabled:true, allow_vote:true, allow_vote_persisted:true, pending_end_lsn:{lsn:62445520168318}, scan_disk_log_finished:true, last_check_start_id:1787923266, is_changing_config_with_arb:false, reconfirm_start_time_us:1787840433617537, palf_role_change_cb:0xfffade7c6930, allow_vote:true}, [ConfigMgr]={palf_id:1004, self:“1xx.xx.xx:2882”, alive_paxos_memberlist:3{server:“xx.xx.xx.xx:2882”, timestamp:1, flag:0}{server:“xxx.xx.xx.xx:2882”, timestamp:1, flag:0}{server:“xxx.xx.xx.xxx:2882”, timestamp:1, flag:0}, alive_paxos_replica_num:3, log_ms_meta:{version:3, proposal_id:10, prev:{version:1, config:{config_version:{proposal_id:9, config_seq:245}, log_sync_memberlist:3{server:“1xx.xx.xx.xx:2882”, timestamp:1, flag:0}{server:“xxx.x.xx.xx:2882”, timestamp:1, flag:0}{server:“xxx.xx.xx.xxx:2882”, timestamp:1, flag:0}, log_sync_replica_num:3, arbitration_member:{server:“0.0.0.0:0”, timestamp:-1, flag:0}, learnerlist:{learner_num:0, learner_array:[]}, degraded_learnerlist:{learner_num:0, learner_array:[]}}, lock_meta:{version:1, lock_type:0, lock_owner:6500, lock_time:1780675216204095}}, curr:{version:1, config:{config_version:{proposal_id:10, config_seq:246}, log_sync_memberlist:3{server:“xxx.xxx.xx:2882”, tim
- 检查补副本参数开启
select*from gv$ob_parameters where name like '%rereplica%';
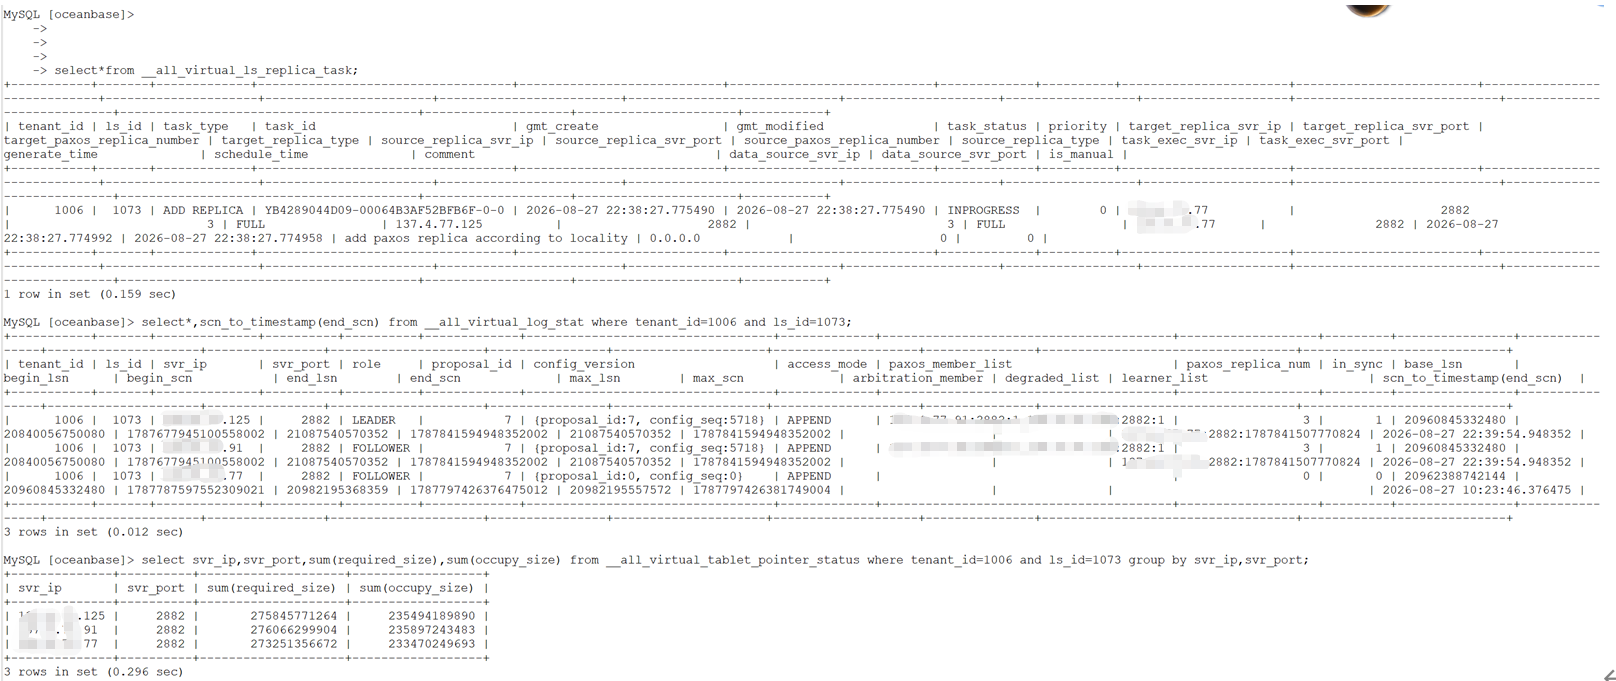
- 上述其他日志流处理完毕后,处理日志流无法同步的节点,进行日志流清理
MySQL [oceanbase]> ALTER SYSTEM REMOVE REPLICA LS 1073 SERVER '1xx.x.xx.77:2882' TENANT 'xxxx';
Query OK, 0 rows affected (0.025 sec)
- 检查日志流状态
- 确认日志流同步完成
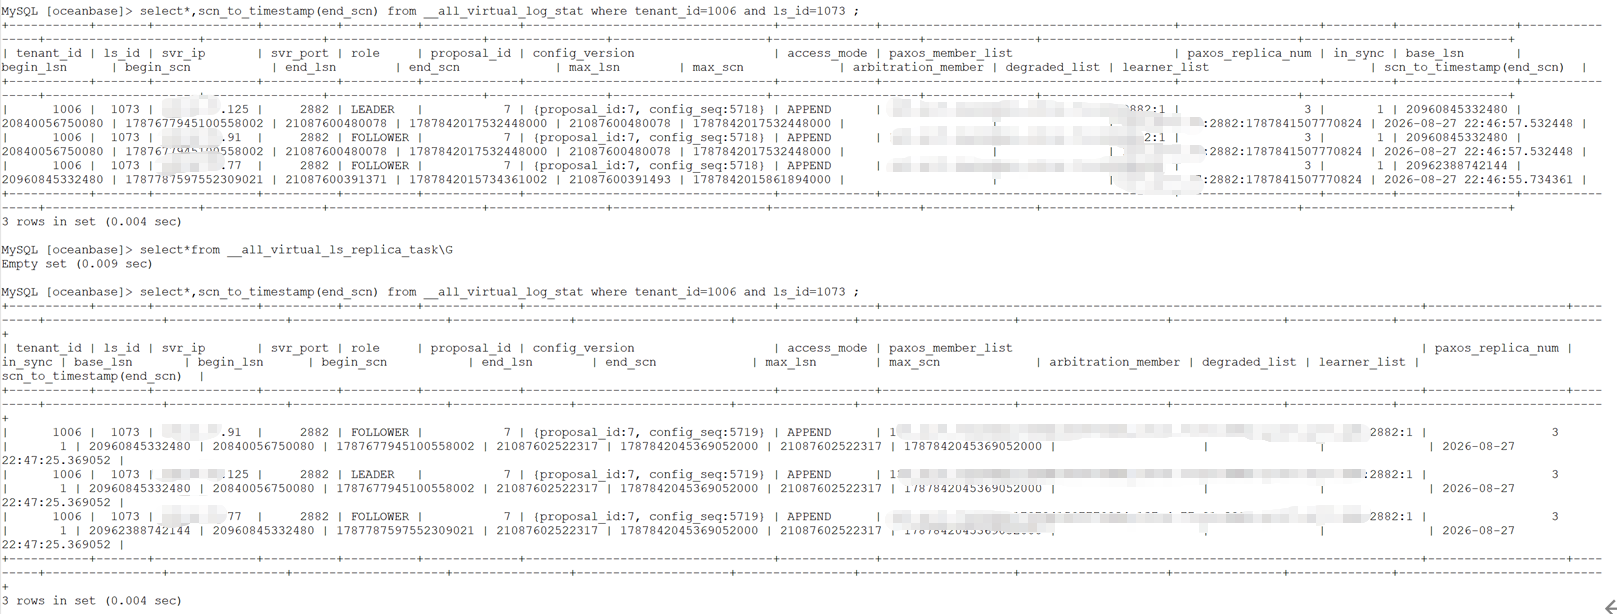
- 检查合并正常完成
总结:
1、clog的滑动窗口,leader预期是32M,follower预期是40M,
(1)对于leader,滑动窗口里日志滑出的条件是日志在多数派都持久化完成
(2)对于follower,leader发来的每一条日志都有一个commited_end_lsn,表示leader上已提交的日志的位点,当一条日志放到滑动窗口里时,会同步更新follower看见的最大的commited_end_lsn,使得滑动窗口里位点最小的日志能滑出
2、对于正常情况,每一条日志的commited_end_lsn与他的end_lsn之间的差值不超过leader滑动窗口的大小32MB,因此follower上40MB的滑动窗口,能保证第一条日志想滑出时,标记了他可以滑出的日志一定能放进滑动窗口
但是这次的问题是,leader的滑动窗口大小变成了40M,导致日志end_lsn-commited_end_lsn最大可以到40M,因此follower上没有足够的空间放使得第一条日志滑出的日志,因此follower上滑动窗口满了,无法滑出任何日志
3、对于这个clog滑动窗口的问题,目前无法确定出现这个问题的第一现场是什么时候,无法从日志中去排查,目前尝试内部复现,但是这个场景不明确,比较难复现
4、对于这个clog问题为什么导致卡合并,原因是因为1073日志流的·滑动窗口的commited_end_lsn没有推进,也就可以说77上发生 PALF 本地提交点停滞。这个会导致weak read SCN一直停在2026-08-26 11:10:52.513904。合并要求weak read SCN > merge_version,也就是要大于开始合并的时间。因为1073日志流一直没有达到这个标准所以并不调度tablet合并,表现就是合并一直卡着不结束,副本没有合并推进的进度
原因触发和版本修复:
原因observer的版本缺陷,1073日志流卡住了合并,主要是因为1073的leader日志流滑动窗口无法划出,通过删除副本方式解决该问题,后续会发版修复,暂时不能明确修复版本,规划4258的大版本上修复,具体还需要通过csm侧同步。
研发复现触发条件 :日志流leader节点在之前某次切主,选举模块短暂卸任又重新上任+这段时间里内存紧张就有可能出现leader 40MB滑动窗口的问题,这个leader切主可能是很久之前的并不会影响使用,但是当后期再次出现问题比如大批量数据写入,导致follow副本同步滑动窗口满导致卡住无法同步,就会触发合并卡卡住。
后期该问题排查处理手段:
- 合并卡住
- 检查诊断视图
select * from GV$OB_COMPACTION_DIAGNOSE_INFO; - 查看日志流同步状态
select * FROM oceanbase.GV$OB_LOG_STAT where TENANT_ID=1006; - 根据以上信息,过滤日志判断是否为一致问题
grep ‘PALF.DUMP’ observer.log grep ‘available_buffer_size:41943040’ grep ‘LEADER’ sed -nE ‘s/.*[T([0-9]+)].palf_id=:./tenant_id=\1 palf_id=\2/p’ sort -u