
【 使用环境 】生产环境 or 测试环境
【 OB or 其他组件 】OCP OB
【 使用版本 】OCP 4.4.2. OB 4.4.2
【问题描述】清晰明确描述问题
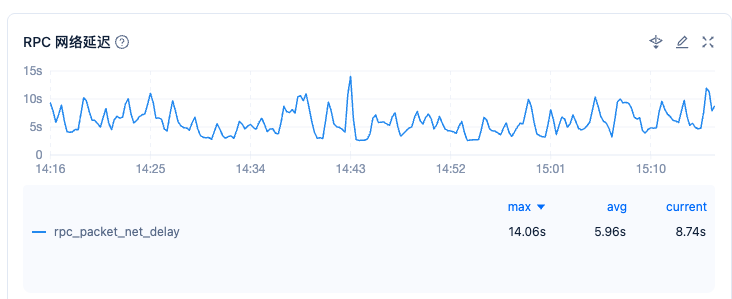
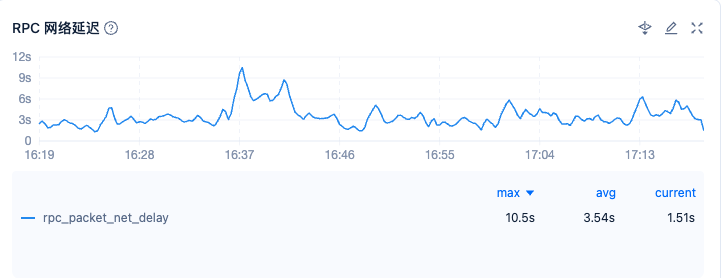
请问下这个指标延迟在5-10秒左右,这个正常吗
【 使用环境 】生产环境 or 测试环境
【 OB or 其他组件 】OCP OB
【 使用版本 】OCP 4.4.2. OB 4.4.2
【问题描述】清晰明确描述问题
请问下这个指标延迟在5-10秒左右,这个正常吗
看着不太正常 应该在ms级吧 你这个是单副本的的还是多副本的 发一下这个时间段的observer.log日志
observer.log.20260913215254862.zip (26.7 MB)
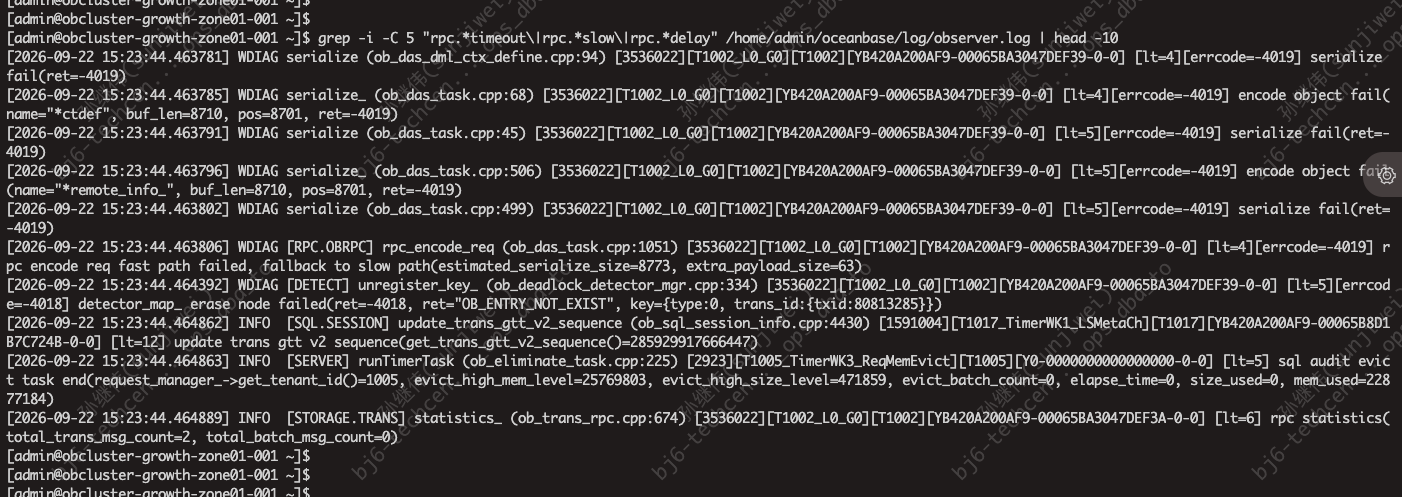
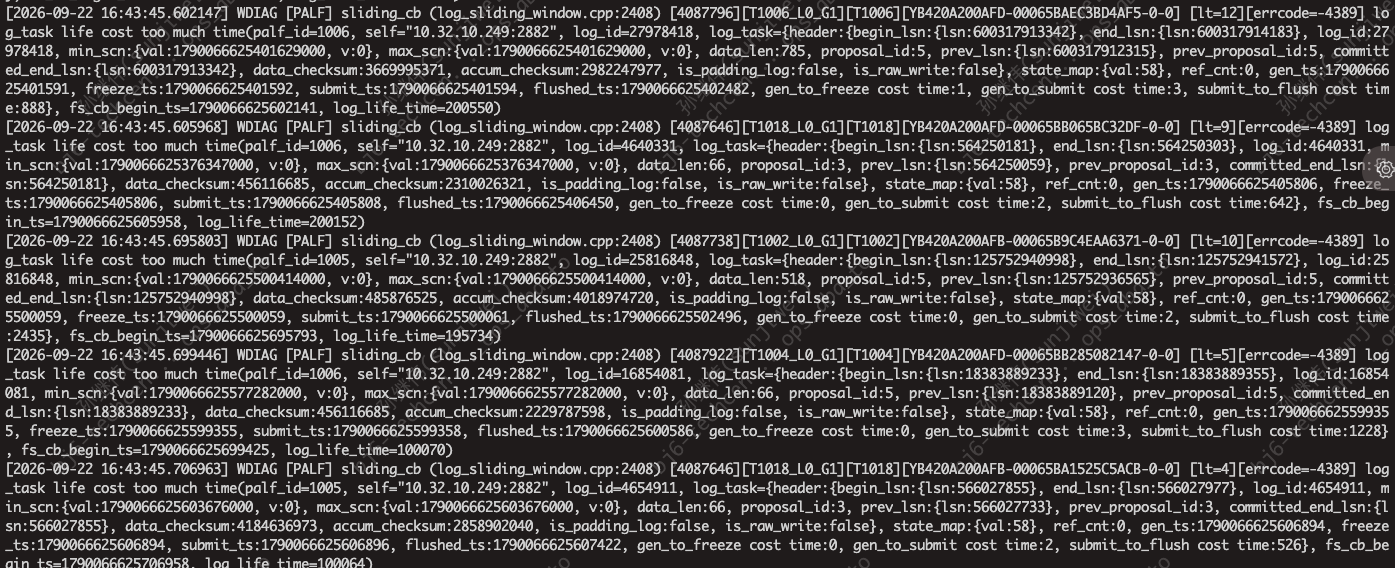
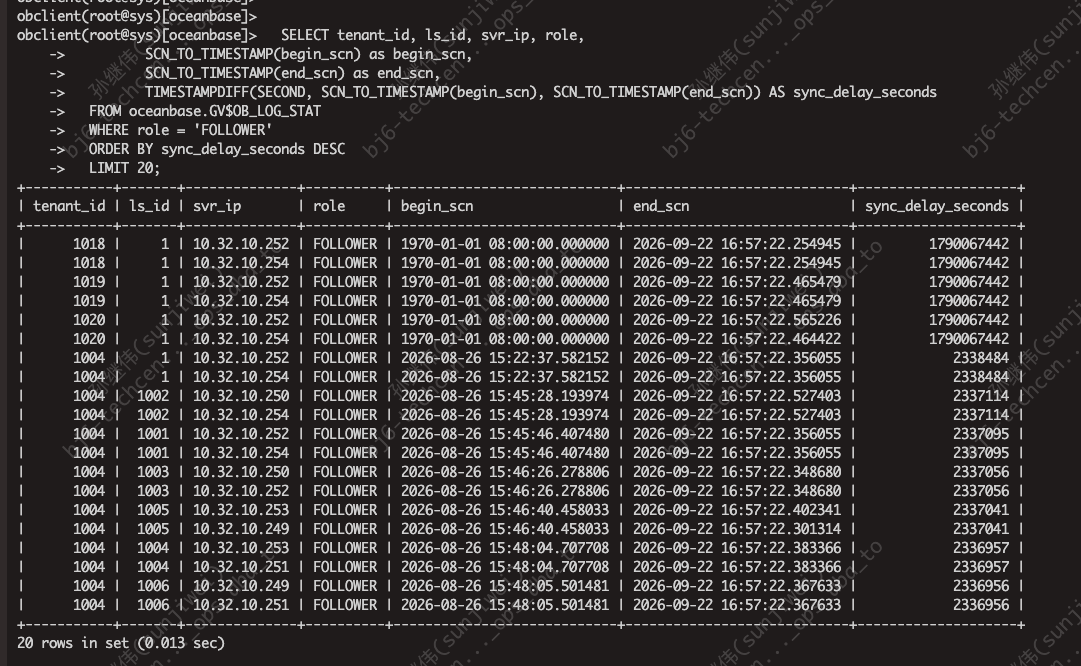
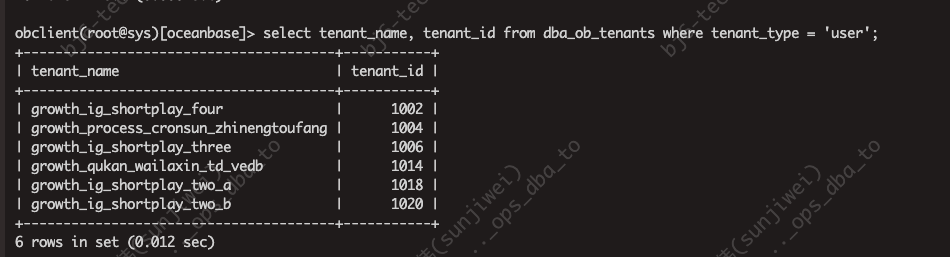
这个租户的这个指标时时刻刻都是这么多,日志如上,然后这个集群的其他租户我看了,会好点,但是也在2秒左右,集群是3zone * 2节点,
然后我们有个情况,是每个observer 都部署启动了chronyd 的,但是节点上不能执行clockdiff 命令,因为我们用的rocky linux 9.5 这个操作系统有个小bug 这个clockdiff命令,所以在使用ocp 部署observer 的时候,clockdiff 检查这一步我是手动跳过的,不知道和这个有没有关系
但是我还有个集群,也是这个情况,这个集群的租户里这个指标都是正常的,在100ms到五六百毫秒之间
WDIAG [SERVER] get_network_speed_from_sysfs (ob_server.cpp:3186)
errcode=-4002 get invalid Ethernet speed, use default(devname=“eth0”)
WDIAG [SERVER] runTimerTask (ob_server.cpp:3553)
errcode=-4002 ObRefreshNetworkSpeedTask reload bandwidth throttle limit failed
看着是 网卡 eth0 速度检测持续失败
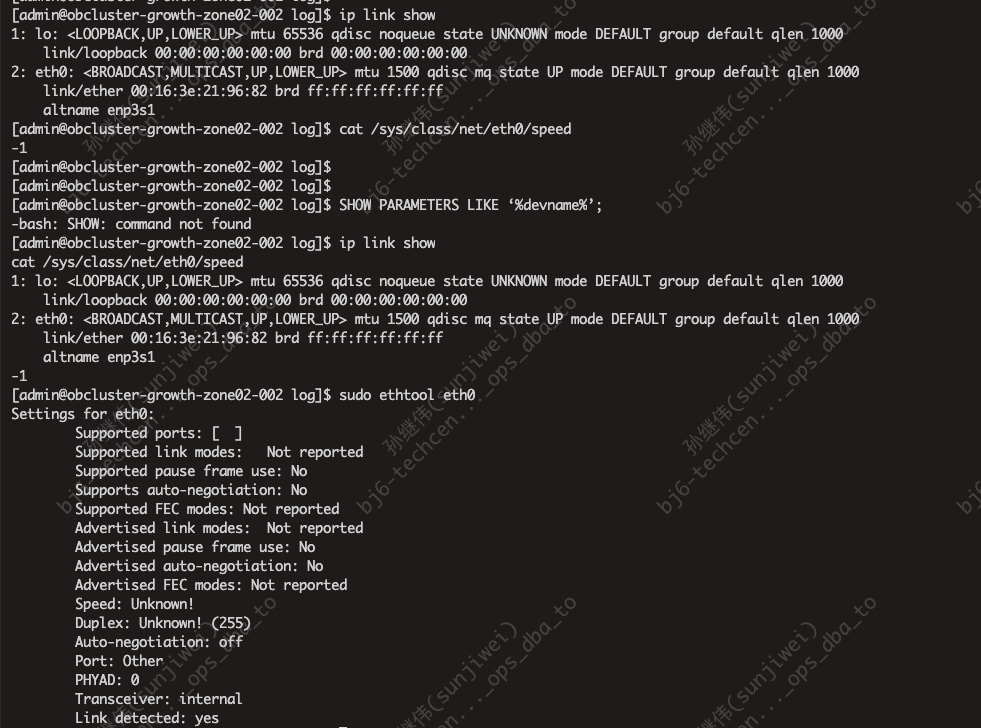
– 1. 检查实际网卡名(可能不是 eth0)
ip link show
cat /sys/class/net/eth0/speed # 如果报错说明网卡名不对
– 2. 如果网卡名是 ens33/enp0s3 等,查看一下信息
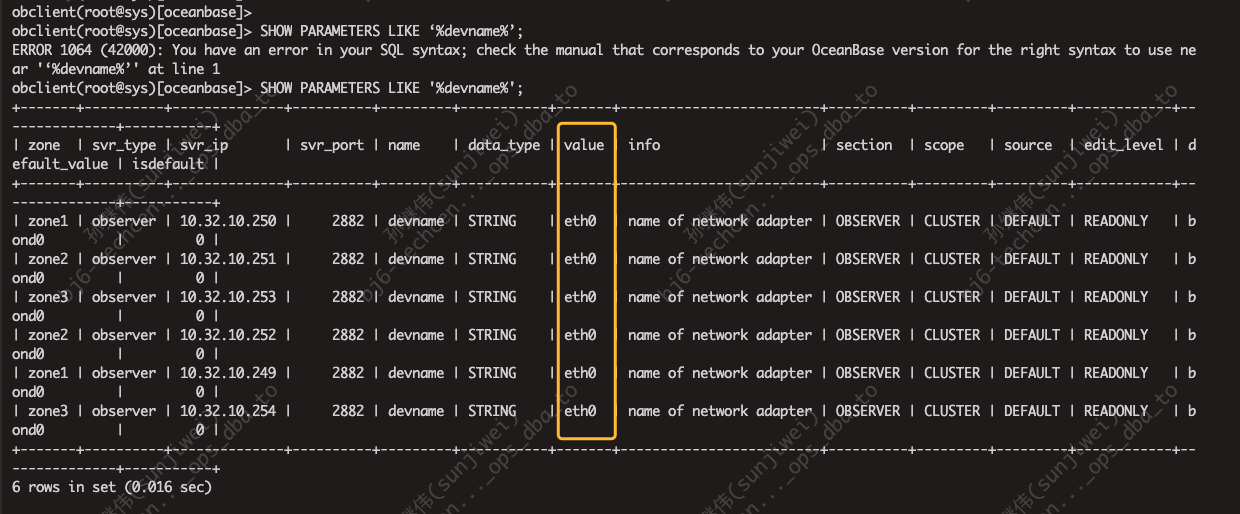
SHOW PARAMETERS LIKE ‘%devname%’;
是的 应该给你们的机器有关系 由于 devname 参数是 READONLY ,不能通过 ALTER SYSTEM 修改,需要在操作系统层面解决:
– 在所有 6 个节点上执行
– 方法 A:直接写入 sysfs(临时生效,重启丢失)
echo 10000 > /sys/class/net/eth0/speed # 写入 10000Mbps (万兆) 根据你们的网卡设置
–验证
cat /sys/class/net/eth0/speed # 应返回 10000
– 方法 B:通过 ethtool 设置(部分虚拟化环境支持)
sudo ethtool -s eth0 speed 10000 duplex full
这个如果不处理,会有什么隐性的问题嘛还是也没啥问题就是这个监控指标看着高,下面这个是我询问的我们购买的ecs的网络情况,看起来最大是能到万兆,和ob要求的是能达到的
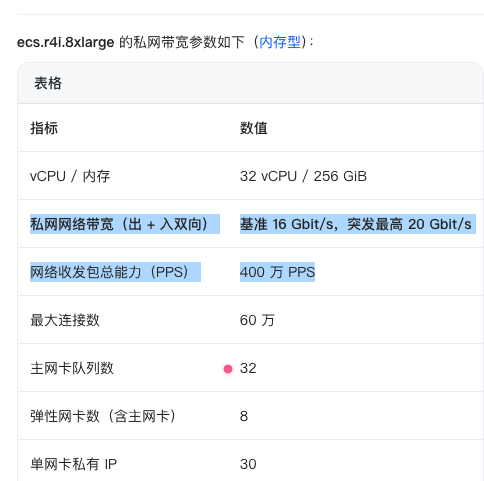
嗯嗯 那你设置一下 因为ob要读取这个信息 目前应该是找不到 后面可以永久写入 把临时的改掉
好的,多谢
WDIAG [SERVER] get_network_speed_from_sysfs (ob_server.cpp:3186)
errcode=-4002 get invalid Ethernet speed, use default(devname=“eth0”)
WDIAG [SERVER] runTimerTask (ob_server.cpp:3553)
errcode=-4002 ObRefreshNetworkSpeedTask reload bandwidth throttle limit failed
这个看日志现在没有报错了,但是延迟依然没有降下来,
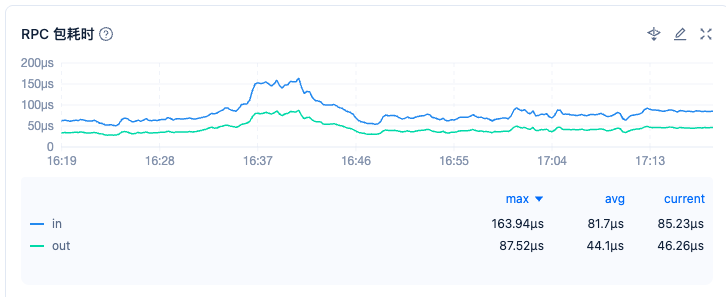
这两个指标有什么区别,一个很高,一个很低
这个没问题,都在0.0几毫秒,
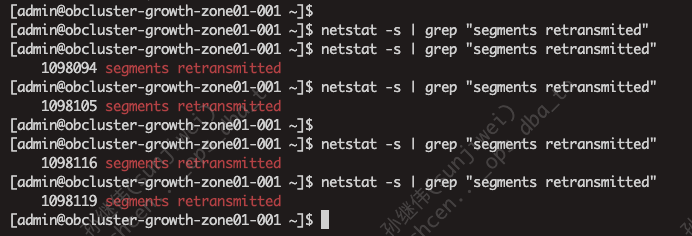
这个看着是在增长的
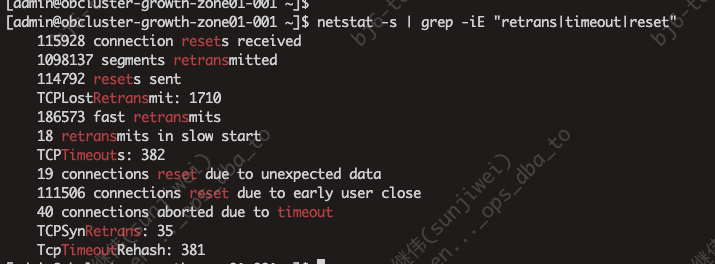
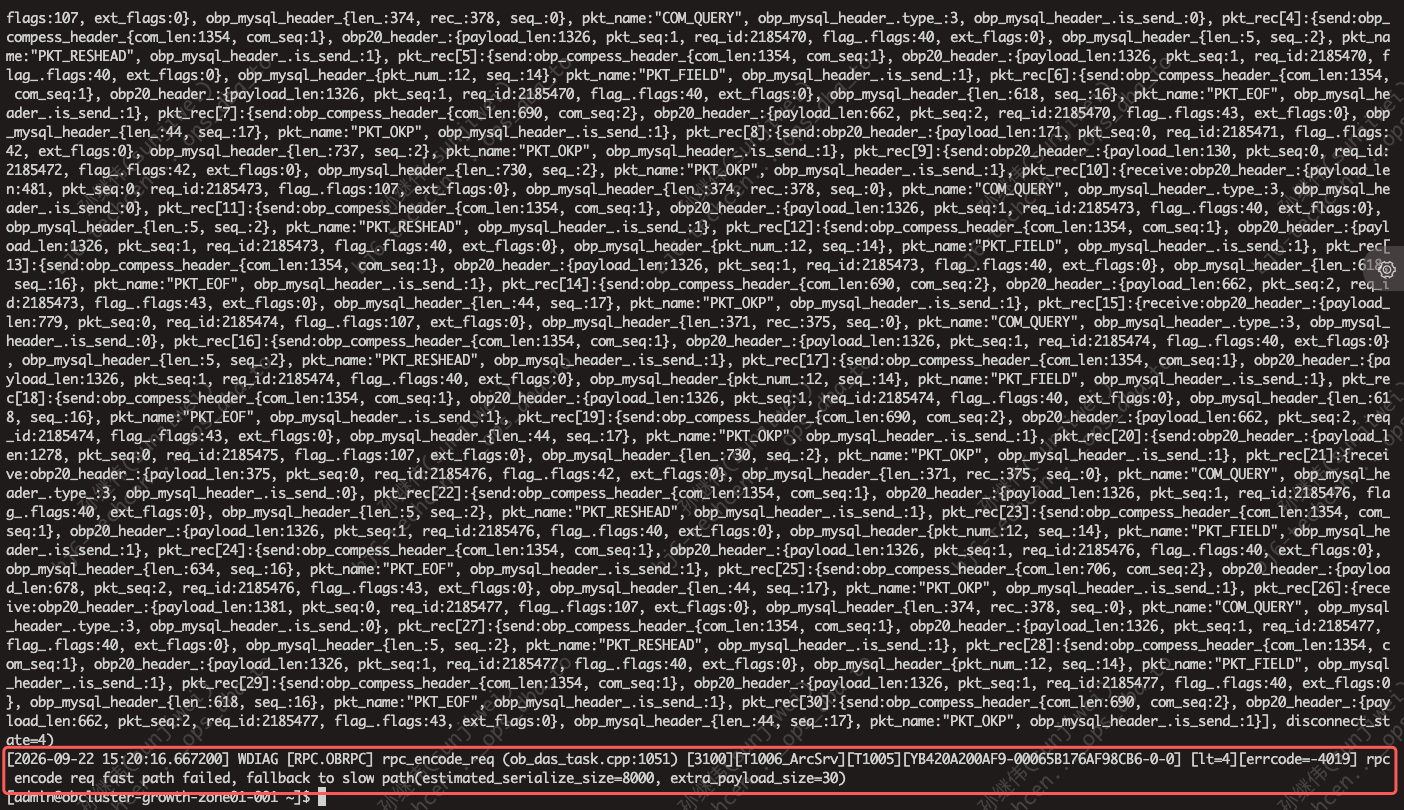
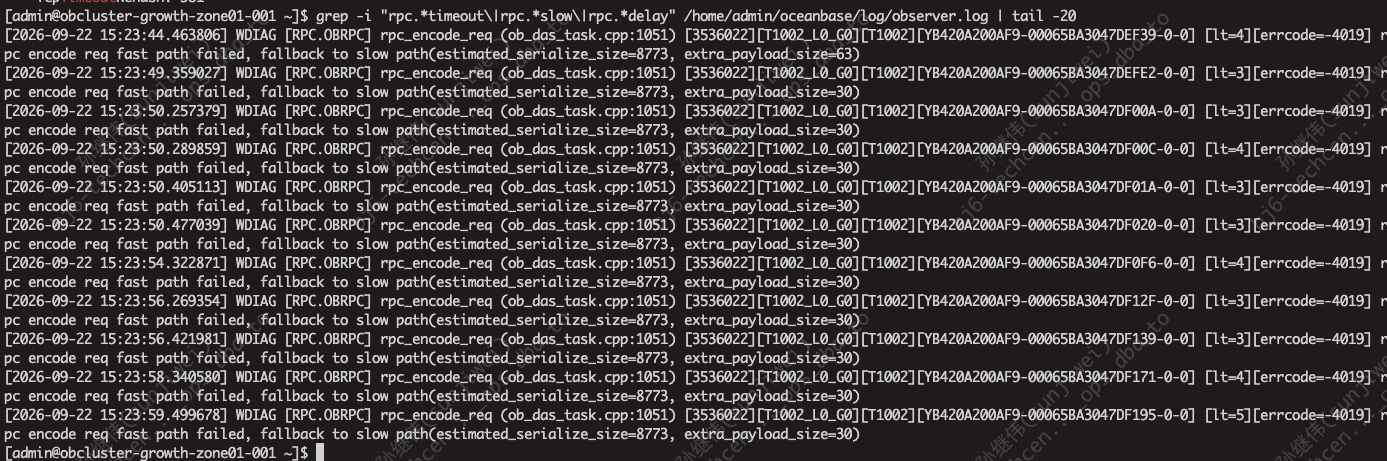
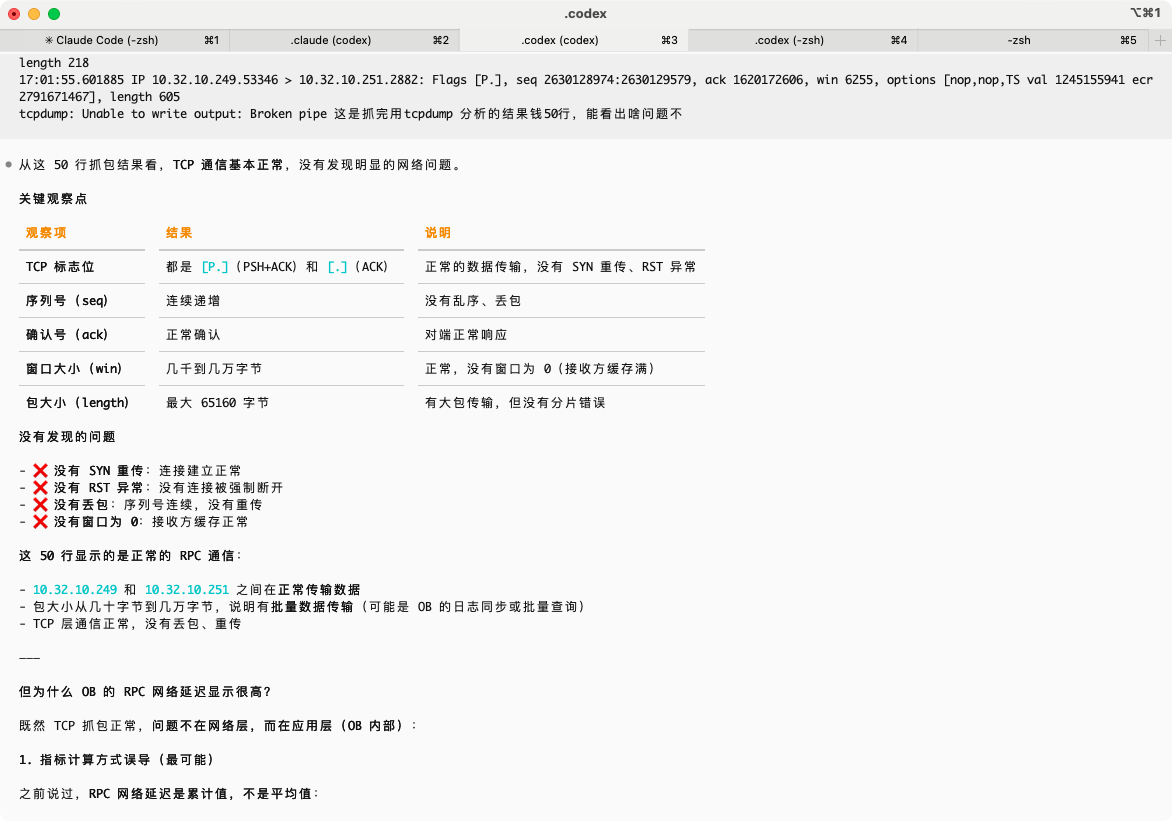
这是抓完包,tcpdump分析后,让ai看了下分析结果
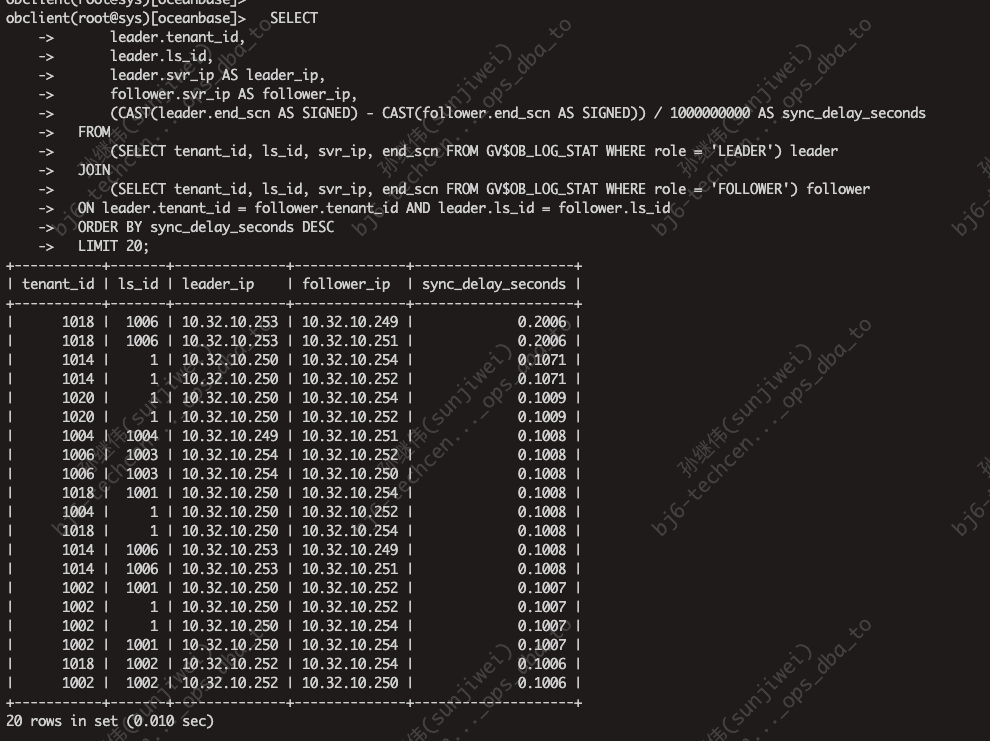
– 确认集群的 zone 分布和副本位置
我们所有机器是在同一个机房,所以不存在机房间延迟
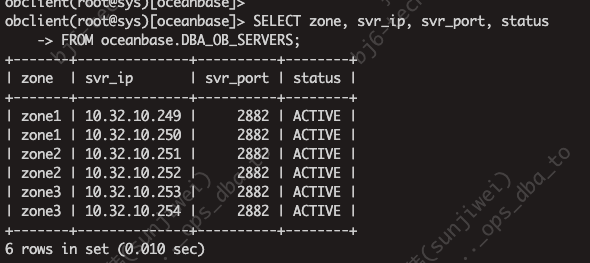
以上是检查结果,帮忙看下能看出啥问题不
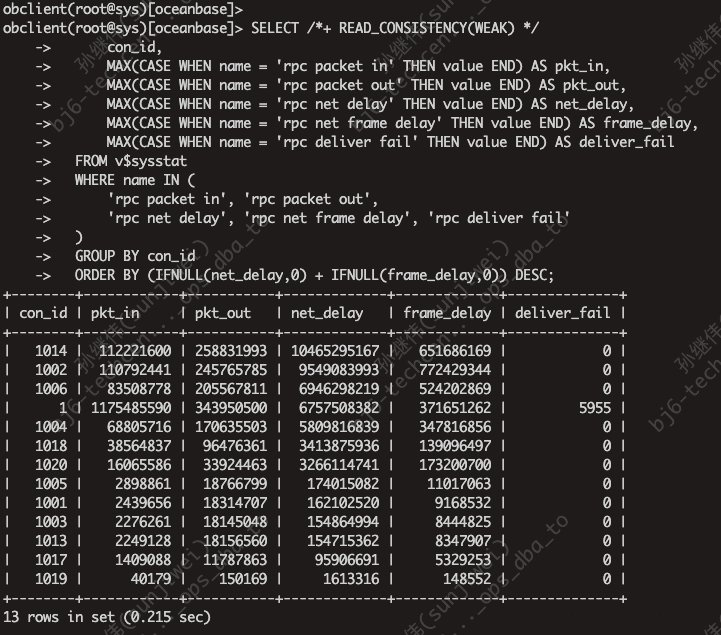
sys租户查一下 看看
SELECT /*+ READ_CONSISTENCY(WEAK) */
con_id,
MAX(CASE WHEN name = ‘rpc packet in’ THEN value END) AS pkt_in,
MAX(CASE WHEN name = ‘rpc packet out’ THEN value END) AS pkt_out,
MAX(CASE WHEN name = ‘rpc net delay’ THEN value END) AS net_delay,
MAX(CASE WHEN name = ‘rpc net frame delay’ THEN value END) AS frame_delay,
MAX(CASE WHEN name = ‘rpc deliver fail’ THEN value END) AS deliver_fail
FROM v$sysstat
WHERE name IN (
‘rpc packet in’,‘rpc packet out’,
‘rpc net delay’,‘rpc net frame delay’,‘rpc deliver fail’
)
GROUP BY con_id
ORDER BY (IFNULL(net_delay,0)+IFNULL(frame_delay,0)) DESC;
看着延迟不高 应该没啥问题 你在观察看看集群是否有问题
行,集群目前没啥问题
RPC网络延迟 = RPC包耗时*RPC数据包数量 是这样计算的 如果RPC包耗时不高的话 可能给发包的数量有关系
好的,那先观察观察吧,rpc 包耗时是很低的