
【 使用环境 】生产环境 or 测试环境
【 OB or 其他组件 】ob
【 使用版本 】4.4.2 社区版
【问题描述】清晰明确描述问题
我们昨晚九点到九点四十之间,有一个租户的请求都打到了其中一个节点(集群六个节点),导致这个节点cpu 打爆,其他节点cpu 使用率极低,请问这个怎么排查原因,找了一些文章看到了一些情况可能比较类似,但是无法排查出是不是
【 使用环境 】生产环境 or 测试环境
【 OB or 其他组件 】ob
【 使用版本 】4.4.2 社区版
【问题描述】清晰明确描述问题
我们昨晚九点到九点四十之间,有一个租户的请求都打到了其中一个节点(集群六个节点),导致这个节点cpu 打爆,其他节点cpu 使用率极低,请问这个怎么排查原因,找了一些文章看到了一些情况可能比较类似,但是无法排查出是不是
另外当时拿一些sql 执行explain route 结果如下,这个看起来是先使用USE_PARTITION_LOCATION_LOOKUP 路由,找不到分区所在节点,又使用USE_CACHED_SESSION路由导致所有的请求都打到一个节点上了,但是这个为什么找不到分区所在节点呢
ROUTE_INFO
[INFO] Will do table partition location lookup to decide which OBServer to route to
TABLE_ENTRY_LOOKUP_DONE
[INFO] No available entry because table entry lookup failed
ROUTE_INFO
[INFO] Will route to cached connected server(10.32.10.250:2881)
ROUTE_POLICY
[INFO] All OBServers are treated as the SAME_IDC with OBProxy because ‘proxy_idc_name’ is not configured
SQL_PARSE:{cmd:“OB_MYSQL_COM_QUERY”, table:“marketing_hourly_data”}
ROUTE_INFO:{route_info_type:“USE_PARTITION_LOCATION_LOOKUP”}
LOCATION_CACHE_LOOKUP:{mode:“oceanbase”}
TABLE_ENTRY_LOOKUP_START:{}
FETCH_TABLE_RELATED_DATA:{table_entry:“partition information does not exist”}
TABLE_ENTRY_LOOKUP_DONE:{is_lookup_succ:true, entry_from_remote:false}
ROUTE_INFO:{route_info_type:“USE_CACHED_SESSION”, svr_addr:“10.32.10.250:2881”}
ROUTE_POLICY:{route_policy:"", chosen_server:“Invalid”}
CONGESTION_CONTROL:{svr_addr:“10.32.10.250:2881”}
把有问题的时间段的obproxy的日志打包都发一下
日志没了,之前没注意obproxy 日志目录的参数大小,用的默认值,只能保存几个小时的
我看有个文档中说到了这个路由失败时临时解决方案,
obproxy 中修改这两个参数,
enable_cached_server用于控制 ODP 计算路由失败情况下是否根据租户 Primary Zone 优先级进行路由,True:根据租户 Primary Zone 优先级进行路由,False:路由失败的情况下进行随机路由
enable_cached_server用于控制是否在没有表项(table_entry)时使用缓存的服务器会话,
True:使用,False:不使用
ALTER PROXY CONFIG SET enable_cached_server = false;
ALTER PROXY CONFIG SET enable_primary_zone = false;
我对这个有点疑问,enable_cached_server 这个参数如果设置为false,让随机路由,不根据Primary Zone 优先级进行路由, 那insert 操作怎么办,如果路由到follower 副本上,不是就无法写入了嘛
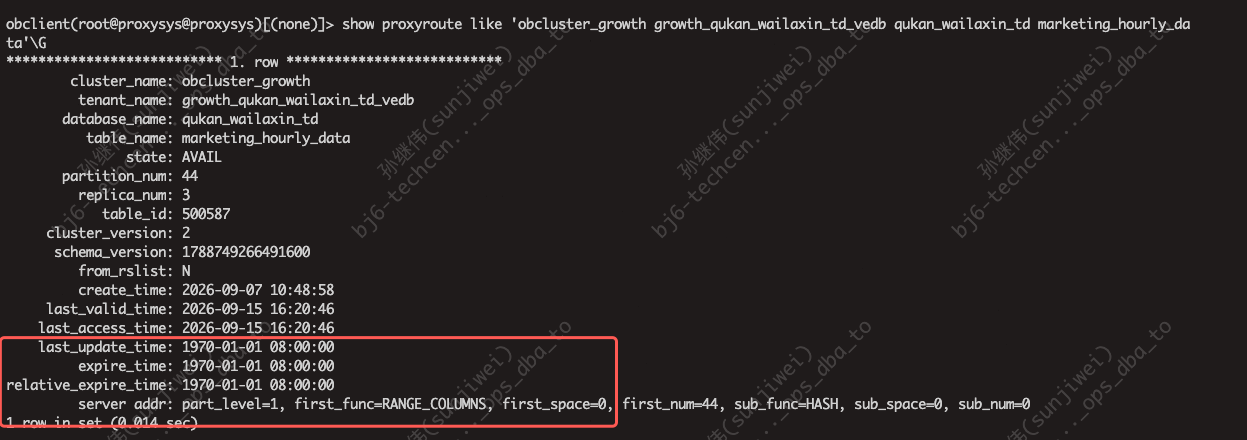
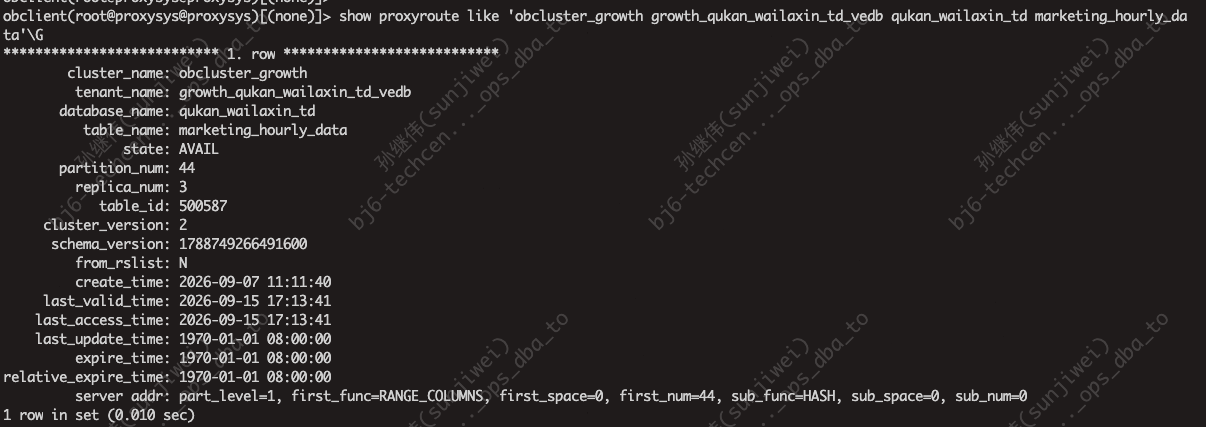
show proxyroute like ‘…marketing_hourly_data’ 所有的odp都查看一下
从日志信息来看确实是 USE_PARTITION_LOCATION_LOOKUP 路由失败后降级为 USE_CACHED_SESSION ,导致所有请求打到同一个节点没有日志不好判断为什么会集中到一个节点上了
enable_primary_zone 控制 → 是否按 Primary Zone 优先级路由enable_cached_server 控制 → 是否复用缓存的会话连接两个都设 false → 走随机路由。
–随机路由到 Follower,INSERT 怎么办?
不用担心。OceanBase 的架构保证了即使请求被路由到 Follower 副本所在节点,INSERT 也能正确执行。
enable_cached_server = true 是导致流量集中到一个节点的(所有请求复用同一个缓存连接)
建议用 enable_cached_server=false, enable_primary_zone=true ,这样路由失败时流量分散到 Primary Zone 的多个节点
好的,我试下,多谢
你们的odp是哪个版本的呀
4.3.6.1 这个版本,
有命令能强制刷新odp 中 某个表的路由信息 吗,让odp 能重新找到分区所在节点,
我看就两个表的请求量很大,然后就 这两个表路由有问题,其他的表我执行show proxyroute like 看都是正常的
刷新单表 没有这个命令
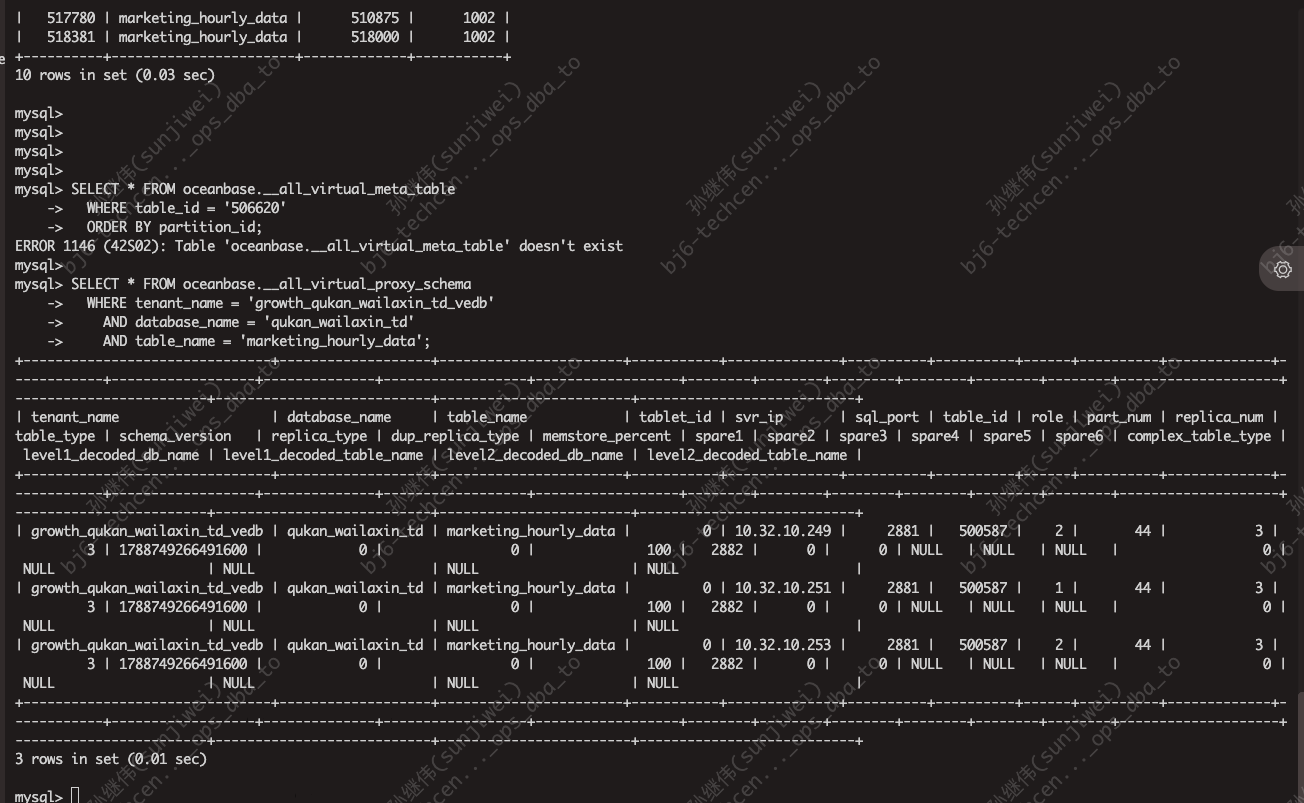
sys 租户连 ODP,查询 SELECT * FROM __all_virtual_proxy_schema WHERE tenant_name='你的租户' AND table_name='你的表' 你试一下这样可以不 触发 ODP 重新拉取该表路由
这个我试了,不行,而且我重启了obproxy也不行,这两个表依然有问题,会不会是这个表有啥问题,按理说如果这个表有啥问题,那今天的路由肯定也有问题的,我怎么搜日志能看下,我搜下面这些都没搜到
grep “partition information does not exist” obproxy.log.* | less
grep “USE_PARTITION_LOCATION_LOOKUP” obproxy.log.* | less
grep “USE_CACHED_SESSION” obproxy.log.* | less
重启以后 应该会重新拉取呀 尽量把odp的日志发一下
用 sys 租户直连 OBServer 2881 端口 (不是连 ODP),查这两张表:
-- ① 查 __all_virtual_meta_table 确认分区是否有 leader
SELECT * FROM oceanbase.__all_virtual_meta_table
  WHERE table_id = <你问题表的 table_id>
  ORDER BY partition_id;

-- ② 查 __all_virtual_proxy_schema 确认 OBServer 是否有该表的路由信息
SELECT * FROM oceanbase.__all_virtual_proxy_schema
  WHERE tenant_name = '<你的租户名>'
    AND database_name = '<库名>'
    AND table_name = '<表名>';
-- 先确认当前连接的租户
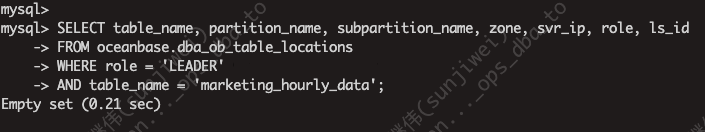
SELECT tenant();

-- 再查,去掉 role 条件,看是否有任何记录
SELECT table_name, partition_name, role, zone, svr_ip, ls_id
FROM oceanbase.dba_ob_table_locations
WHERE table_name = 'marketing_hourly_data';

-- 如果上面也是空,试一下模糊匹配
SELECT table_name, partition_name, role, zone, svr_ip
FROM oceanbase.dba_ob_table_locations
WHERE table_name LIKE '%marketing_hourly%';
-- sys 租户直连 OBServer 2881 端口
-- 查这个表的所有分区的路由信息
SELECT tenant_name, table_name, tablet_id, partition_id, svr_ip, role
FROM oceanbase.__all_virtual_proxy_schema
WHERE tenant_name = 'growth_qukan_wailaxin_td_vedb'
  AND database_name = 'qukan_wailaxin_td'
  AND table_name = 'marketing_hourly_data'
ORDER BY partition_id, svr_ip;
-- 必须用 growth_qukan_wailaxin_td_vedb 租户连接,不是 sys!
obclient -h<odp_ip> -P2883 -u<user>@growth_qukan_wailaxin_td_vedb -p<password>

SELECT table_name, partition_name, tablet_id, ls_id, svr_ip, role
FROM oceanbase.dba_ob_table_locations
WHERE table_name = 'marketing_hourly_data'
ORDER BY partition_name;
在查一下 信息 看看
SELECT table_name, partition_name, tablet_id, ls_id, svr_ip, role
FROM oceanbase.dba_ob_table_locations
WHERE table_name = ‘marketing_hourly_data’
ORDER BY partition_name;
-- 查看该表在 OBServer 侧的分区 tablet 分布
SELECT table_id, tablet_id, partition_id, svr_ip, svr_port, role, zone
FROM oceanbase.__all_virtual_tablet_to_table_history
WHERE table_id = 500587;

-- 或者查分区位置信息
SELECT * FROM oceanbase.__all_virtual_partition_info
WHERE table_id = 500587;

-- 查看表的元数据
SELECT table_id,schema_version,table_name, partition_num, partition_type, tablet_id
FROM oceanbase.__all_virtual_table
WHERE table_name = 'marketing_hourly_data';
-- 在 sys 租户下,查所有列,看完整结构
SELECT * FROM oceanbase.__all_virtual_proxy_schema
WHERE tenant_name = 'growth_qukan_wailaxin_td_vedb'
AND database_name = 'qukan_wailaxin_td'
AND table_name = 'marketing_hourly_data'\G
-- 查看 RootService 状态
SELECT svr_ip, svr_port, role, status
FROM oceanbase.DBA_OB_ROOTSERVICE;

-- 检查事发时段是否有 RootService 切换
SELECT * FROM oceanbase.DBA_OB_ROOTSERVICE_EVENT
WHERE gmt_create BETWEEN '2026-09-14 20:00:00' AND '2026-09-14 22:00:00';
把上面的信息 都在查一下 具体再看看
– 验证 __all_virtual_proxy_partition 是否能正常返回数据
-- 在 sys 租户下查询该表的分区信息(OBProxy 就是从这里获取的)
SELECT * FROM oceanbase.__all_virtual_proxy_partition
WHERE tenant_name = 'growth_qukan_wailaxin_td_vedb'
AND database_name = 'qukan_wailaxin_td'
AND table_name = 'marketing_hourly_data'\G
– 验证 __all_virtual_proxy_ls_location 的 LS 位置信息
SELECT * FROM oceanbase.__all_virtual_proxy_ls_location
WHERE tenant_name = 'growth_qukan_wailaxin_td_vedb'
ORDER BY ls_id, svr_ip;
– 对比两个视图的节点一致性
-- __all_virtual_proxy_ls_location 中的节点(过滤 LOGONLY)
SELECT DISTINCT svr_ip
FROM oceanbase.__all_virtual_proxy_ls_location
WHERE tenant_name = 'growth_qukan_wailaxin_td_vedb'
AND role != 3
ORDER BY svr_ip;

-- __all_virtual_proxy_schema 中的节点
SELECT DISTINCT svr_ip
FROM oceanbase.__all_virtual_proxy_schema
WHERE tenant_name = 'growth_qukan_wailaxin_td_vedb'
ORDER BY svr_ip;
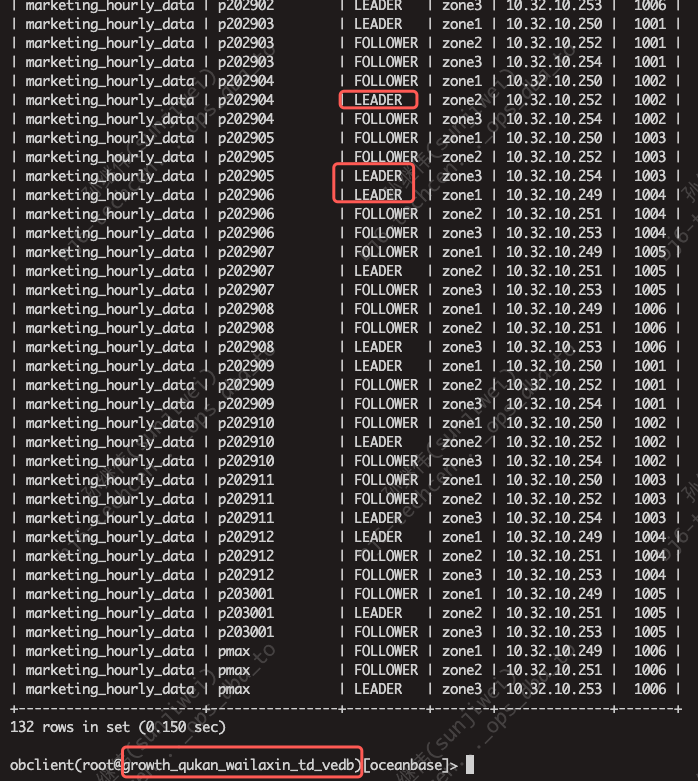
在growth_qukan_wailaxin_td_vedb 租户的查询情况如下:
SELECT table_name, partition_name, tablet_id, ls_id, svr_ip, role
FROM oceanbase.dba_ob_table_locations
WHERE table_name = ‘marketing_hourly_data’
ORDER BY partition_name;
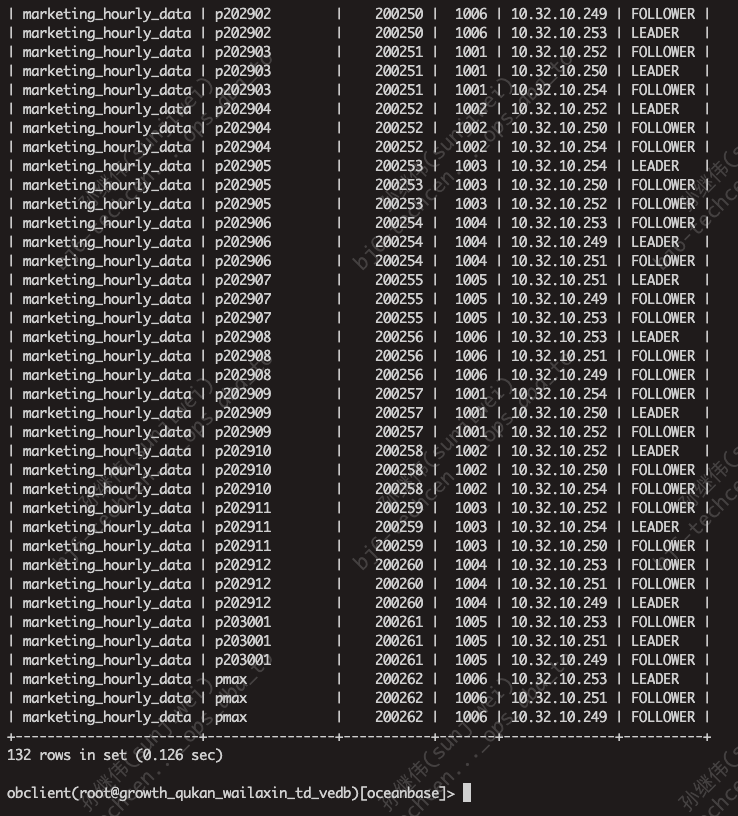
查看该表在 OBServer 侧的分区 tablet 分布,oceanbase.__all_virtual_tablet_to_table_history 这个表不存在,我换成 SELECT table_name, table_id, object_id, partition_name,
zone, svr_ip, svr_port, role, tablet_id, ls_id
FROM oceanbase.DBA_OB_TABLE_LOCATIONS
WHERE table_id = 500587
ORDER BY partition_name, zone, svr_ip; 这个查的
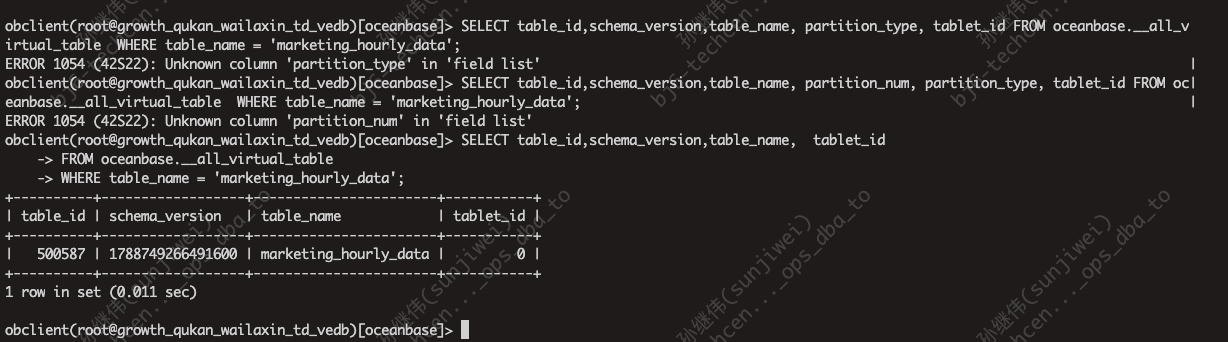
分区位置信息,表也不存在
查看表的元数据
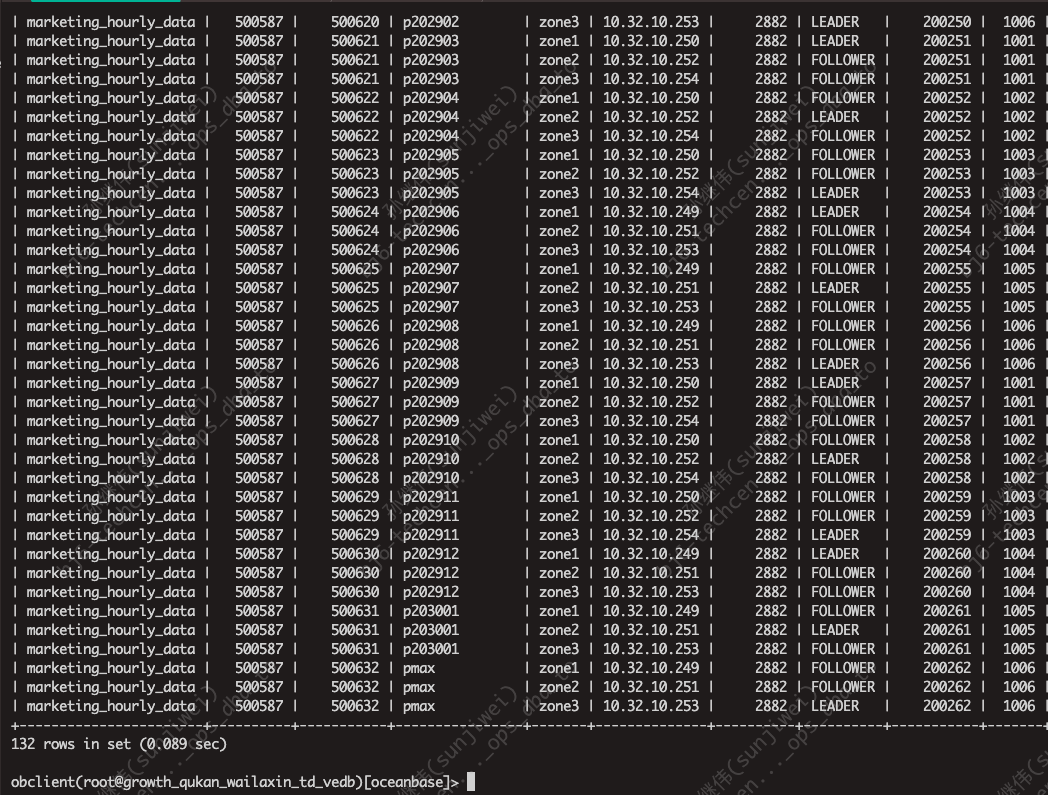
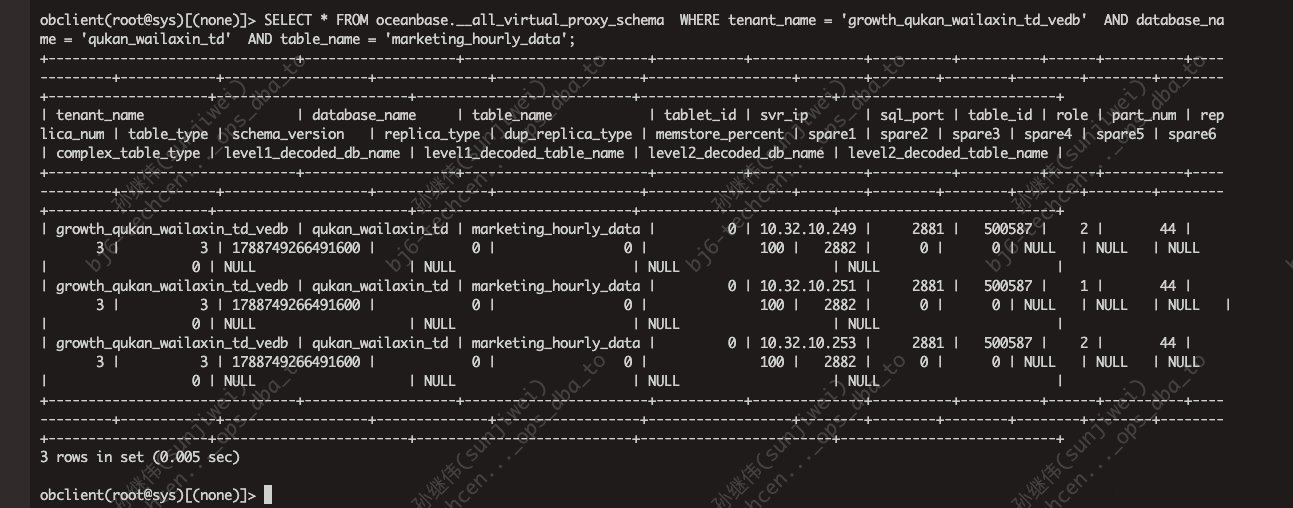
以下是sys租户查询情况
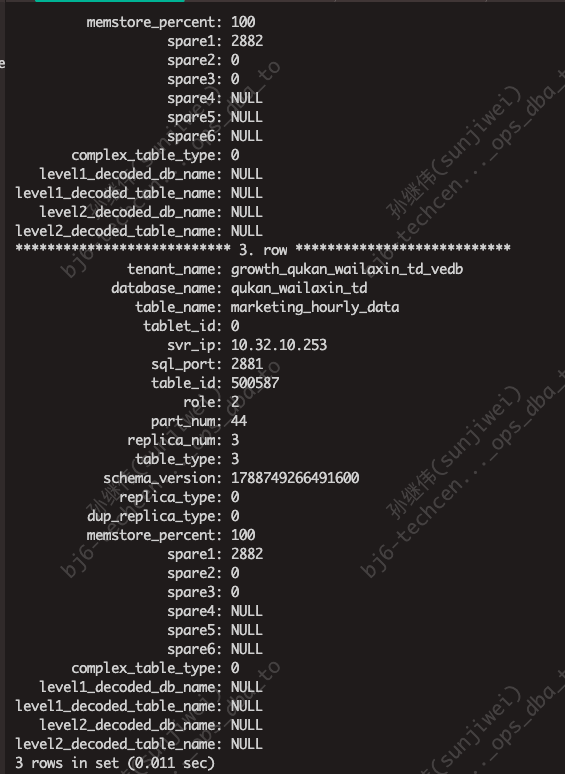
查所有列,看完整结构
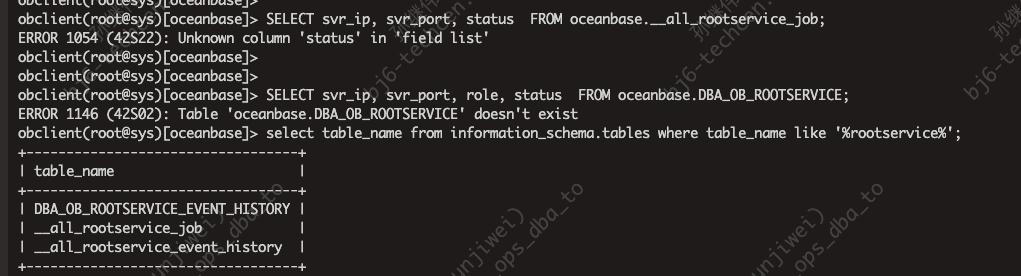
查看 RootService 状态, 看起来没有相关的表
检查事发时段是否有 RootService 切换, gmt_create 没有这个字段,改成了timestamp 这个字段,结果太多,放到result.txt 这个文件里了
另外,昨晚没有再发生,但是这个表我看路由还是没有的,我下载了近两个小时的 两个日志,每个256MB,不让上传,为啥,是对文件大小有限制吗