
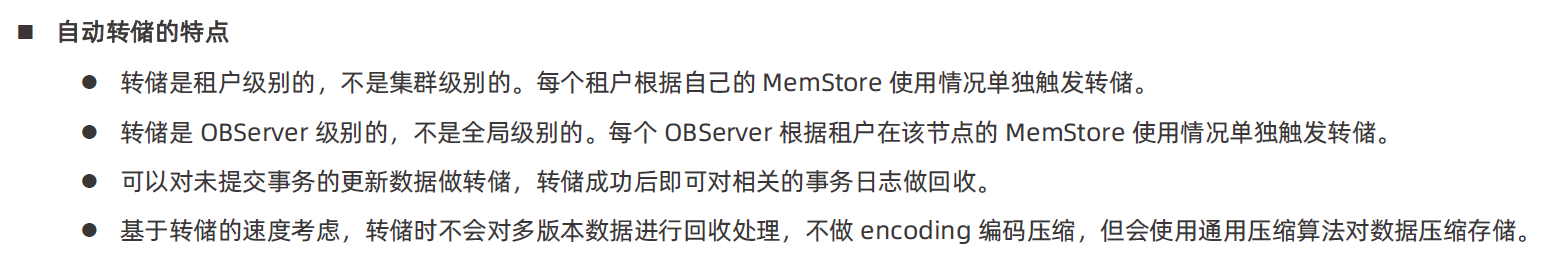
1.转储是不是基于租户在observer的memstore使用情况进行转储,即租户+observer粒度;
2.未提交的事务做了转储等于是转储跨一个事务的生命周期,事务回滚怎么办?
3.转储不做编码压缩,只做通用压缩。但前面讲的是数据存储是第一次编码压缩(合并时),第二次通用压缩。是不是矛盾,这里说说不会对多版本合并回收。
问题 1:转储粒度是不是 租户 + OBServer?
 是的。
- 转储不是集群全局,也不是单纯租户级别:每个 OBServer 节点上,按该租户在本节点的 MemStore 内存占用触发转储。
- 同一个租户,节点 A 内存满了触发转储;节点 B 内存没到阈值就不转储。粒度 = 租户 × OBServer。
问题 2:未提交事务的数据被转储到磁盘,如果事务回滚怎么办?
转储只是把修改版本落盘,不会丢掉事务元信息:
- 未提交事务的数据转储到 SSTable 后,这条记录仍然携带事务 ID、版本号、事务状态。
- 查询的时候,OB 会根据事务状态判断可见性:未提交的数据对其他会话不可见,即使已经在磁盘上。
- 如果事务执行回滚:
- 不会去磁盘 SSTable 里删除那条记录;
- 会生成一条 ** 回滚版本(撤销记录)** 写入 MemStore,后续也会落盘;
- 读取时发现回滚版本,就过滤掉原来未提交的修改,实现回滚效果。
- 转储成功后,可以回收这部分对应的 redo 日志,但是不会清理多版本、不会清理未结束事务相关数据。事务回滚依靠多版本机制,不需要修改已经转储出去的 SSTable 文件。
关键点:转储≠事务提交;转储只落盘变更,事务的原子性、可见性靠多版本 + 事务元数据保证。
问题 3:压缩的矛盾点:转储只用通用压缩,合并才有编码压缩,是否冲突?
 不矛盾,转储(Mini Compaction)和合并(Major Merge)是两个不同阶段,压缩规则不一样。
-
转储(Mini,小合并)
- 目标:尽快把 Memstore 数据刷盘释放内存,优先看重速度。
- 不做 encoding 编码压缩(编码需要扫描解析列数据,CPU 开销大、慢);
- 只做 ** 通用压缩(lz4/snappy/zstd)** 直接对二进制块压缩。
- 同时:转储不会回收多版本数据,多版本还全部保留在生成的 SSTable 里。
-
合并(Major Merge,大合并)
- 后台把多个 SSTable 重写整理;
- 第一次:Encoding 编码压缩(字典编码等列语义压缩);
- 第二次:再做通用压缩;
- 合并阶段才会清理回收过期多版本数据。
总结:两次压缩是合并阶段完整流程;转储只是快速刷盘,只跑通用压缩,编码压缩留到合并的时候执行,所以不存在矛盾。
自动转储核心特点回顾
- 粒度:租户 + OBServer,单节点租户内存超限就触发,不影响其他节点;
- 支持转储未提交事务数据,依靠 MVCC 事务元信息处理回滚,转储成功后可以回收对应 redo 日志;
- 转储追求速度:不做编码压缩、不回收多版本,仅通用压缩;多版本回收、encoding 编码压缩全部交给 ** 合并 (Major Merge)** 完成。
1 个赞
感谢大佬详细解答,受益匪浅。